Viktigheten av presisjon i KI-debatten

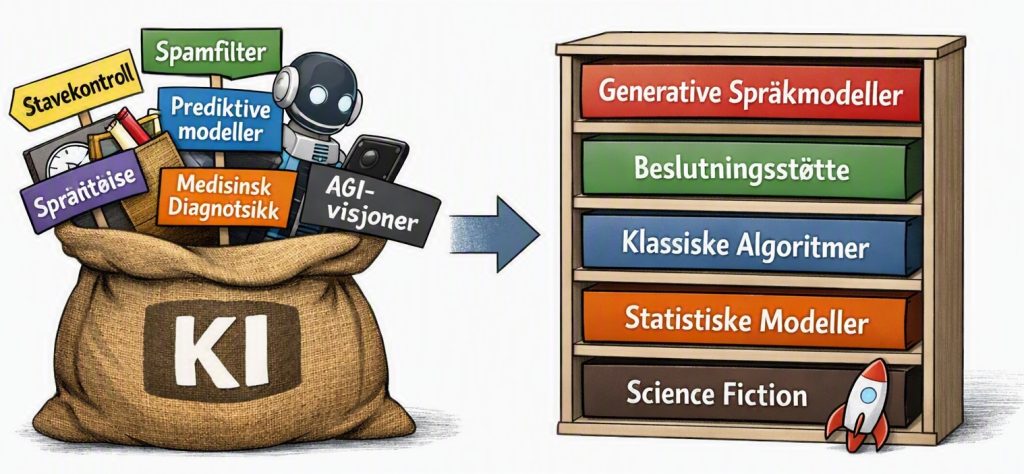
Illustrasjon laget av Microsoft Copilot basert på innholdet i dette innlegget. Legg merke til det lilla skiltet til venstre. Er dette Copilots versjon av «Sprøyt og tøys»? Uansett; det sier noe om hva statistisk generering av tekst kan lede til…

Så hva er kunstig intelligens? Først og fremst er det et gammelt fagfelt med et misvisende navn. Som helhet har fagfeltet vært en skuffelse, fordi ordet «intelligens» antyder et løfte disse løsningene aldri har vært i nærheten av å innfri. Samtidig er ideer derfra blitt brukt til å lage IT-løsninger i flere tiår.

Bjørn Stærk, 2023 (1)

Debatten om kunstig intelligens er i ferd med å bli en samtale full av store ord og små presisjoner. Når sekkebegrepet «KI» brukes om alt og ingenting forsvinner viktige forskjeller mellom teknologier, bruksområder og risikoer. Det gjør oss dårligere rustet til å ta gode beslutninger både politisk og utdanningsmessig.

Hva mener vi når vi sier «KI»

Strictly speaking, AI is not a technology at all. Facial-recognition software, translation and speech recognition programs, scheduling algorithms, and predictive models might all have different machine learning tools running in the background, but it is patently absurd to refer to them as a singular technology. We do not call everything containing copper wires «wiring»

– R.H. Lossin, PhD. og J. Resnikoff, PhD., 2024 (2)

Begrepet «kunstig intelligens» dekker et vidt spekter av ulike teknologiske løsninger som i flere tiår har vært, og fortsatt er, en del av vår digitale hverdag: fra stavekontroll og autokorrektur, sjakkprogrammer, medisinske diagnosesystemer, stemmegjenkjenningsverktøy, semantisk søk i Google, spam-filtre, enkle statistiske modeller som forutsier strømpriser, via dagens generative språkmodeller som skriver tekst, til visjoner om kunstig generell intelligens (AGI).

Å snakke om «KI» som om det var én ting er misvisende. Mange av dagens mest omtalte systemer så som ChatGPT, Microsoft Copilot og Gemini, er i realiteten statistiske tekstgeneratorer som setter sammen ord basert på mønstre i store datasett. De fremstår tilsynelatende intelligente, men de «forstår» ikke på samme måte som mennesker gjør. Å bruke begreper som «forstår», «tenker» eller «vil» skaper antropomorfisering som forvirrer mer enn den oppklarer.

Hvorfor presisjon er viktig

One problem with the term “artificial intelligence” is that it gets tossed around so carelessly. The current AI chatbot narrative centers around the use of natural language processing (NLP), for example, but Google Search has been using NLP in its search results for a long time. AI is a marketing term used to generate hype, and the tech media is buying right into it.

– Skyler Schain, 2023 (3)

«KI er alt det en datamaskin ikke kan gjøre ennå» er et sitat kreditert IT-forskeren Larry Tesler, men formulert som et teorem av Douglas Hofstadter i Gödel, Escher, Bach. Teslers egen foretrukne formulering var mer direkte. Intelligens, sa han, er det maskiner ennå ikke har gjort (Masood, 2026).

Med utgangspunkt i Teslers formulering og det som kalles «KI-effekten», vil jeg hevde at uten presisjon blir reguleringer og retningslinjer for bruk av såkalt «KI» unøyaktige og lite relevante. Når vi ikke skiller mellom ulike teknologier og systemer, blander vi sammen helt ulike problemstillinger: opphavsrett og kildebruk ved tekstgenerering, hallusinasjoner og faktasikkerhet i undervisning, algoritmisk skjevhet i beslutningsstøtte, og sikkerhetskrav i medisinsk diagnostikk. Risikoen er kontekstavhengig: kravene til dokumentasjon, validering og ansvar må være strengere der feil kan skade mennesker direkte, og mer pragmatiske der konsekvensene er lave.

Et godt eksempel er den kommende «KI-loven». Når sekkebegrepet «KI» benyttes ukritisk kan vi få et reelt problem med lovforståelsen. Hvis ledere i offentlig og privat sektor tror at en enkel statistisk modell skal reguleres like strengt som et medisinsk diagnosesystem, kan det kvele innovasjon og skape unødvendig byråkrati.

Og kombinasjonen av et omfattende sekkebegrep og manglende forståelse for datateknologi kan fort føre oss til lover som fokuserer for mye på hypotetiske fremtidsfarer av typen «KI kan utslette menneskeheten», på bekostning av nåværende reelle vitenskapelig forankrede trusler.

Vi mennesker har en naturlige tendens til å tilskrive datamaskiner menneskelige egenskaper som bevissthet, intensjon og generell intelligens. Og denne tendensen blir godt støttet av media og kommersiell hype sin fremstilling av «KI» som noe autonomt og tenkende, istede for avansert sannsynlighetsregning, lineær algebra og mønstergjenkjenning.

Den kommende norske KI-loven virker på meg som et hederlig forsøk på å regulere teknologien basert på konkrete bruksområder og funksjoner, men den abstrakte debatten drukner ofte i myter om kunstig bevissthet.

Så den upresise bruken av sekkebegrepet KI i kombinasjon med medieskapte myter om tenkende enheter, kan føre til misforståelser om hvor de faktiske farene man må regulere ligger. En utpreget frykt for at datasystemer blir «ondskapsfulle», kan tåkelegge at den reelle risikoen i dag handler om diskriminerende treningsdata (bias), ekkokamre, manipulasjon, avhengighetsskapende algoritmer og personvernbrudd.

Med andre ord; vi kan ende opp med å regulerer begrepet «KI» fremfor reelle digitale systemer og disses konkrete funksjoner.

Tre presisjonsfeil som går igjen

At their core, LLMs are nothing more than sophisticated memorization machines, capable of reasonable-sounding statements, but unable to understand fundamental truth. Importantly and despite the fervent hopes of many, they are far from delivering or even prefiguring artificial general intelligence (AGI). The hype surrounding LLMs has reached stratospheric levels, fostering a misguided belief in their potential as AGI precursors

– Matt Asay, 2024 (4)

  • Sekkebetegnelsen «KI»: Når alle systemer samles under ett navn, forsvinner nyansene som trengs for målrettet regulering og god praksis. Når mange utdanningsinstitusjoner ønsket å forby, eller nå forbyr, elever og studenter å “bruke KI” så vil det, om vi skulle ta dette bokstavelig, omfatte så mange verktøy at all digital teknologi fort kan omfattes. Men det vi egentlig har snakket om siden 2022/ 2023 er et forbud mot å bruke samtaleroboter av typen ChatGPT eller Copilot i visse situasjoner.
  • Blanding av virkelighet og science fiction: Eventyrscenarier om maskiner som foretar egne valg helt utenfor det de er programmert for tar  oppmerksomheten bort fra at vi står midt i en teknologisk utvikling som svekker vår individuelle dømmekraft, devaluerer den politiske og kulturelle verdien av selvstendig menneskelig refleksjon og truer demokratiets evne til å skille mellom velfundert kunnskap og glattformulert uvitenhet. Og dette skyldes ikke at datamaskiner er blitt intelligente og tar over makten, men at vi lar kommersielle aktører og ikke forskning få lov til å definere hva som er virkelig.
  • Antropomorfisering: Å tillegge systemene menneskelige intensjoner eller bevissthet fører til feilaktige forventninger og ansvarsvakuum. Hvorfor skal vi kreve at selskaper som OpenAI tar ansvar for det de leverer når vi samtidig tror blindt på at datamaskiner nå har fått selvstendig evne til å tenke og handle uavhengig av sine programmerere?

Et konkret eksempel fra egen undervisning

Språkmodeller er lagd for å skrive gode setninger, ikke for å undersøke virkeligheten

– Førsteamanuensis Inga Strümke, 2025 (5)

Som foreleser i teknologirelaterte fag i grenselandet mellom samfunnsvitenskap og humaniora (IKT og læring 1 og 2, ORG5005) og med over 20 års erfaring både med studentaktiv undervisning, konstruksjon av arbeidskrav i tråd med Blooms taksonomi og digital distribusjon av undervisning, er det en selvfølge at mine studenter har lov til å bruke samtaleroboter som del av sine arbeider med ulike arbeidskrav. Og som teknolog kaster jeg like selvfølgelig ikke bort tiden med å bruke såkalte «KI-detektorer» på studentenes innleveringer. Det jeg ser etter er ikke formalia og struktur (at en universitetsstudent er i stand til å følge oppsatte formalia og strukturere en besvarelse er en selvfølge), men innholdet. Er besvarelsen preget av grundige drøftinger og analyser av de momenter et arbeidskrav omfatter og der studentens egen yrkeserfaring er koblet både til tematikken i oppgavene og til relevant faglitteratur? Eller er det kun et 9 siders «essay» som like gjerne kunne vært skrevet av en ungdomsskole- eller videregående elev?

Så mine studenter må altså gjerne benytte seg av språkmodeller som støtte, men de i hvert arbeidskrav de leverer skrive en egenerklæring om bruk/ ikke bruk av KI. Og når jeg her benytter forkortelsen «KI» så er det for lettvinthetsskyld, siden studentene allerede er vant med en slik overforenkling. Men i retningslinjene, i de generelle veiledningene og i et eget kapittel om «KI» i fagemnenes FAQer, presiseres følgende: «Nevn hvilken type samtalerobot du har benyttet og vær konkret når du beskriver bruken».

For når studentene kun skriver «jeg har brukt KI» i sine egenerklæringer, så åpner det for stor usikkerhet. Har studenten benyttet avanserte stave- og gramatikk kontroll-program eller andre system som ikke lengre ansees som «KI», men som studenten oppfatter som «intelligente system»? I så fall er jo dette egentlig ikke interessant gitt den debatt som har rast i de akademiske søylehaller siden november 2022. For det vi som undervisere og sensorer ønsker å vite, er jo om det er tekstgeneratorer av typen Copilot eller Gemeni som er benyttet.

Så for å få meningsfull dokumentasjon på studentenes bruk av disse verktøyene må vi be om presise opplysninger: hvilken samtalerobot og hva ble denne konkret benyttet til; ideutvikling, formulering, kildekritikk eller ren tekstproduksjon. Uten slike detaljer blir en egenerklæring om bruk/ ikke bruk av “KI” ubrukelig og vil skape utfordringer for både vurdering av studentenes teoretiske arbeider og for studentenes evne til å skille mellom science fact og science fiction når de skal vurdere hva «KI» konkret er som begrep og som enkeltverktøy i helt spesifikke tilfelle.

Når studenter allerede innledningsvis i en besvarelse blir tvunget til å beskrive presist hvilke spesifike samtaleroboter de benyttet og hva de faktisk benyttet dette verktøyet til, utvikler de samtidig en klarere forståelse av hva slike verktøy er og ikke er. En slik første forståelse av skillet mellom konkrete funksjoner og diffuse forestillinger om “KI” er vesentlig for studentenes videre arbeid med de ulike arbeidskrav fra utkast, via veiledning, til mappestenging, og derigjennom viktig for studentenes daglige ansvar for opplæring og instruksjon av andre i egen yrkeshverdag.

Forslag til mer presisjon når vi snakker om «KI»

Artificial intelligence is often talked about as a single technology. This is unhelpful. AI is an umbrella term covering a wide range of technologies, from translation tools and recommendation engines to predictive models and the LLMs that power ChatGPT and many generative and agentic AI systems. These technologies have different lineages, are designed for very different purposes, work in different ways and raise different questions. Yet, they are routinely bundled together under the single label of AI; a simplification that obscures important distinctions and makes informed discussion and decision-making far more difficult than it should be.

Jo Morrison, PhD. , 2026 (6)

En artikkel på Khrono publisert 31.08 i år har overskriften «Her har sensorene forbud mot å bruke KI». Gitt hvor mange ulike dataprogram og systemer som omfattes av dette sekkebegrepet blir det litt av en oppgave både for sensorer og utdanningsinstitusjoner å holde styr på hvilke digitale verktøy dette forbudet skal gjelde. Men selvsagt er det her kun snakk om samtaleroboter.

En mer presis begrepsbruk, fortrinnsvis basert på faktisk innsikt i KI‑feltets terminologi, kunne gitt både artikkelen i Khrono og den generelle diskusjonen et etterlengtet løft, og kanskje til og med redusert den kollektive forvirringen.

Som samfunnsinformatiker mener jeg derfor at vi nå snarest bør:

  • Bruk mer presise begreper: Snakk om «generative språkmodeller», «bildesyntese», «prediktive modeller» eller «samtaleroboter» i stedet for bare «KI».
  • Kontekstualiser risiko: Still krav etter hvor kritisk bruken er. Rettslige beslutninger og eksamensvurdering krever høyere sikkerhetsmarginer enn kreative skriveoppgaver.
  • Konkret regulering: Vi bør ikke regulere ideen om «KI» som om det var en konkret og handlende entitet. Det som må reguleres er identifiserbare aktørers utvikling, anskaffelse og bruk av bestemte systemfunksjoner i konkrete institusjonelle sammenhenger, ut fra hvilke data som behandles, hvem som berøres, hvilken beslutningsmakt systemet får, og hvor alvorlige konsekvensene kan bli.
  • Unngå menneskeliggjøring: Beskriv hva systemene gjør rent teknisk, så som mønstergjenkjenning, sannsynlighetsberegning, statistisk generalisering og ikke hva de «tenker».
  • Skille mellom hype og empirisk kunnskap: Politikere, utdanningsinstitusjoner og KI-utvalg (både nasjonale og lokale) bør basere retningslinjer for såkalt “KI-bruk” på forskning og ikke leverandørers markedsføring via mer eller mindre fantasifulle mediehistorier.

Avslutning

Many people assume artificial intelligence is a purely 2020s phenomenon tied to chatbots. In reality, AI research produced working systems long before generative AI existed. This includes chess-playing programs, medical diagnosis systems, and voice recognition tools developed across the 1960s, 1970s, 1980s, and 1990s. IBM’s Deep Blue defeated world chess champion Garry Kasparov in 1997, using techniques built decades into the field’s history, not a recent invention.

What changed more recently was not the existence of the field, but the emergence of one specific technique: deep learning using large neural networks. That technique combined with the availability of enormous datasets and specialized computing hardware. Together, they produced the generative AI systems now familiar to most people. Still, this represents one chapter within a much longer research history, rather than the beginning of the story

Cris Tolomia, 2026 (7)

Presisjon i språket er ikke bare akademisk pedanteri. Det er et praktisk verktøy for å gjøre debatten nyttig og handlingsrettet. Når vi klarer å skille mellom teknologier, bruksområder og reelle risikoer, kan vi lage bedre retningslinjer, mer treffsikre reguleringer og mer meningsfull undervisning og vurdering.

Datamaskiner er fortsatt datamaskiner. De er basert på digitale, binære «byggesteiner», ikke mystisk og uforklarlig magi. Siden 2022 har vi fått flere og mer spesialiserte verktøy (akseleratorer, minnetyper, DPUs, kjøleløsninger) for å møte behovene skapt av store språkmodeller, men disse endringene er forbedringer av samme grunnleggende prinsipp. Datamaskiner er fortsatt digitale maskiner som bruker binær logikk (0 og 1) i form av elektriske tilstander og begrensningene som følger av fysikk, strøm, kjøling og nettverk er ikke på mystisk vis plutselig opphevet.

Dette betyr at vi fortsatt er låst til de samme fysiske realitetene som vi har vært i flere tiår. OpenAI, Microsoft og andre kommersielle aktører har ikke funnet opp hjulet på nytt; de har bare bygget en ekstremt spesialisert versjon av det. Den «magien» vi opplever er et resultat av manglende kunnskap om hvordan datamaskiner faktisk funger, rå datakraft og sofistikert matematikk, ikke et brudd med klassisk datateknologi.

La oss derfor slutte å snakke om «KI» som én entitet, og begynne å snakke om de konkrete systemene og situasjonene vi faktisk står overfor.

Se også

Leseliste

  1. Misleading Metaphors and Real Risks
  2. There is no such thing as conscious artificial intelligence
  3. AI as Normal Technology
  4. Fem paradokser ved kunstig intelligens
  5. Who and What comprise AI Skepticism?
  6. Why AI Literacy Matters in 2025
  7. Why AI is not a science
  8. Om kunstig intelligens
  9. The history of artificial intelligenceDel 1Del 2 og Del 3
  10. Understanding the different types of artificial intelligence
  11. Artificial intelligence: How is it different from human intelligence?
  12. Viewpoint: When Will AI Exceed Human Performance? Evidence from AI Experts
  13. Dear laymen, here’s what you got wrong about AI or LLM
  14. The Statistical Magic Behind Chat GPT:How AI Learns to Talk
  15. How Large Language Models work – From zero to ChatGPT
  16. How does ChatGPT generate human-like text?
  17. Unraveling the mysteries of AI chatbots
  18. ChatGPT is not “true AI.” A computer scientist explains why
  19. Calm down folks, ChatGPT isn’t actually an artificial intelligence
  20. ChatGPT is not ‘artificial intelligence.’ It’s theft
  21. Why is ML/ANNs/DL/LLM/GPT/ChatGPT Not-AI and what is the future of AI?
  22. Difference between AI, ML, LLM, and Generative AI
  23. ChatGPT is bullshit
  24. ChatGPT: A Bullshit Tool For Bullshit Jobs
  25. ChatGPT – The Revolutionary Bullshit Parrot
  26. Why Machine Learning is not Artificial Intelligence?
  27. Chatbots Don’t Know What Stuff Isn’t
  28. The stupidity of AI
  29. Why ChatGPT and Bing Chat are so good at making things up
  30. From Eliza to ChatGPT: why people spent 60 years building chatbots
  31. AI now beats humans at basic tasks: Really?
  32. ChatGPT’s Poetry is Incompetent and Banal: A Discussion of (Porter and Machery, 2024)
  33. Generating Medical Errors: GenAI and Erroneous Medical References
  34. Hallucinating Law: Legal Mistakes with Large Language Models are Pervasive
  35. Why ChatGPT-4’s Score on the Bar Exam May Not Be So Impressive
  36. Re-evaluating GPT-4’s bar exam performance
  37. Artificial Intelligence Driving Materials Discovery? Perspective on the Article: Scaling Deep Learning for Materials Discovery
  38. ChatGPT4 failed my pragmatics exam
  39. Bloom’s Taxonomy in the Interaction Between Artificial Intelligence and Human Learning
  40. Four lessons from ChatGPT: Challenges and opportunities for educators
  41. ChatGPT: Bullshit spewer or the end of traditional assessments in higher education? (PDF)
  42. Chatroboten er dårlegare til å løysa likningar enn ein gjengs ungdoms­skulelev
  43. The trouble with Bloom’s taxonomy in an age of AI
  44. Keiserens nye KI-klær
  45. What if Generative AI turned out to be a Dud?
  46. What exactly are the economics of AI?
  47. Why AI detectors think the US Constitution was written by AI
  48. AI Detectors Don’t Work. Here’s What to Do Instead
  49. There Is No Way to Detect AI Content (Here’s the Proof)
  50. 4 Examples That Show You Cannot Trust ZeroGPT and Other AI Detection Tools
  51. OpenAI legger ned verktøy for å avsløre AI-tekst: – Unøyaktig!
  52. There’s a Problem With That App That Detects GPT-Written Text: It’s Not Very Accurate
  53. On the Limits of Artificial Intelligence (AI) in Education
  54. Saying No to AI in Education
  55. Refser akademia for angst­preget KI-tilnærming. — Går baklengs inn i fremtiden
  56. KI i Randabergskolen
  57. Hvordan ChatGPT kan bidra i lærerutdanningens matematikkundervisning
  58. Spørsmål om KI som faglige spørsmål
  59. Lider akademia av teknofobi?
  60. Super-intelligence? No, not even high school intelligence
  61. Artificial Intelligence—The Revolution Hasn’t Happened Yet
  62. The future of generative AI is niche, not generalized
  63. International Scientific Report on the Safety of Advanced AI
  64. What are the risks from Artificial Intelligence?
  65. KI er ikke din venn
  66. ‘Thirsty’ ChatGPT uses four times more water than previously thought
  67. Kunstig intelligens får skylden for et enormt strømforbruk den ikke har
  68. The ethical implications of using generative chatbots in higher education
  69. Unethical and reliable: Why I’m not allowing ChatGPT in my firm
  70. Ett år med ChatGPT
  71. Kirurger som danser
  72. Kunstig intelligens: Innholdet er laget av menn. Algoritmene er laget av menn
  73. Ett år med ChatGPT: Etiske blindsoner, eller lukkede øyne?
  74. ‘It’s destroyed me completely’: Kenyan moderators decry toll of training of AI models
  75. Etikk-eksperter: – Vær varsom ved bruk av kunstig intelligens
  76. The ethics of ChatGPT – Exploring the ethical issues of an emerging technology
  77. Kunstig intelligens: Venn og hjelper, eller hyperkommersiell trussel?
  78. Ikke lov å bruke ChatGPT i skolen når aldersvilkåret er 18 år
  79. OpenAI’s ChatGPT is Breaking GDPR, Says Noyb
  80. Status of all copyright lawsuits v. AI
  81. Er ChatGPT plagiat? – Opphavsrett og Chatbot/ AI
  82. Hvilke juridiske problemstillinger kan oppstå i forbindelse med kunstig intelligens?
  83. OpenAI Sued for Using Copyrighted Material to Train ChatGPT
  84. Hvem eier innholdet som lages av kunstig intelligens?
  85. Employers Should Consider These Risks When Employees Use ChatGPT
  86. ChatGPT is a data privacy nightmare. If you’ve ever posted online, you ought to be concerned
  87. Kunstig intelligens, digitalt krater og oss
  88. Nei, elever med chatboter lærer ikke mer!
  89. Tech Giants Pushing AI Into Schools Is a Huge, Ethically Bankrupt Experiment on Innocent Children That Will Likely End in Disaster
  90. KI-hallusinasjoner har kommet for å bli – det gjør chatboter utfordrende å bruke i opplæring
  91. Studentenes tekstlige identitetskrise
  92. Bekymret for studenters KI-bruk: «Nivået er lavere nå»
  93. AI makes you smarter but none the wiser: The disconnect between performance and metacognition
  94. Your Brain on ChatGPT: Accumulation of Cognitive Debt when Using an AI Assistant for Essay Writing Task
  95. The Impact of Large Language Models on Programming Education and Student Learning Outcomes
  96. How ChatGPT Robs Students of Motivation to Write and Think for Themselves
  97. Is it harmful or helpful? Examining the causes and consequences of generative AI usage among university students
  98. Unge meninger: Få ChatGPT ut av klasserommet!
  99. Tenke sjæl
  100. Kunstig intelligens: Er vi smarte nok ?
  101. Hvordan svarer ChatGPT om kontroversielle temaer?
  102. No, OpenAI’s model did not ‘go rogue’ – and the real story is more useful than the headlines
  103. OpenAI’s Agent Didn’t Hack Hugging Face—They Just Left the Door Open
  104. When it comes to security, LLMs are like Swiss cheese — and that’s going to cause huge problems
  105. THE DARK SIDE OF LARGE LANGUAGE MODELS (2 deler)
  106. CHATGPT – EN TRUSSEL MOT DEMOKRATIET
  107. ChatGPT, Grok, Gemini and other AI chatbots are spewing Russian misinformation, study finds
  108. Social engineering with ChatGPT (.pdf)
  109. Security threats in AIs such as ChatGPT revealed by researchers
  110. Is ChatGPT a cybersecurity threat?
  111. Unveiling the Dark Side of ChatGPT: Exploring Cyberattacks and Enhancing User Awareness
  112. 11 Convincing ChatGPT and AI Scams to Watch out for in 2024
  113. Blir leger dårligere med KI?
  114. Psychiatrists Warn That Talking to AI Is Leading to Severe Mental Health Issues
  115. The Dark Addiction Patterns of Current AI Chatbot Interfaces
  116. Psychiatric Researchers Warn of Grim Psychological Risks for AI Users
  117. As AI becomes more popular, concerns grow over its effect on mental health
  118. Can ChatGPT Be Addictive? A Call to Examine the Shift from Support to Dependence in AI Conversational Large Language Models
  119. Advancing meaningful learning in the age of AI
  120. AI-resistant assessments in higher education: practical insights from faculty training workshops
  121. A Framework for Generative AI-Driven Assessment in Higher Education
  122. Rethinking Assessment in Higher Education in the Age of Generative AI
  123. A neutral toolkit? For a fundamental critique of constructive alignment
  124. Cultivating independent thinkers: The triad of artificial intelligence, Bloom’s taxonomy and critical thinking in assessment pedagogy
  125. Navigating the Jagged Technological Frontier: Field Experimental Evidence of the Effects of AI on Knowledge Worker Productivity and Quality
  126. What if generative AI is not here to stay?
  127. AI myth debunked: ChatGPT usage explains only 3.9% of student plagiarism behavior
  128. Kunstig intelligens og konsekvenser for veiledning på tekstarbeid
  129. The Opposite of Cheating – Teaching for Integrity in the Age of AI
  130. Dette er rådene til studenter og forelesere i den kunstige intelligensens tid
  131. Generative AI, plagiarism, and “cheating”
  132. Eksamen og kunstig intelligens – for faglærar (NTNU)
  133. Veiledning om bruk av samtaleroboter ved Det samfunnsvitenskapelige fakultet, UiB
  134. Informasjon om bruk av kunstig intelligens, UiTø
  135. Generativ kunstig intelligens ved Nord universitet
  136. ChatGPT in education: can you still use take-home exams and essays?
  137. Towards Mitigating ChatGPT’s Negative Impact on Education: Optimizing Question Design through Bloom’s Taxonomy
  138. Assessing ChatGPT’s Mastery of Bloom’s Taxonomy Using Psychosomatic Medicine Exam Questions: Mixed-Methods Study
  139. Comparing the Performance of ChatGPT-4 and Medical Students on MCQs at Varied Levels of Bloom’s Taxonomy
  140. The ChatGPT Artificial Intelligence Chatbot: How Well Does It Answer Accounting Assessment Questions?
  141. The influence of AI text generators on critical thinking skills in UK business schools
  142. “Completely Deprive My Rights to Think”: Analyzing Student Perspectives on the Usefulness of ChatGPT and Its Impact on Higher Order Thinking Skills
  143. A Cross-Era Discourse on ChatGPT’s Influence in Higher Education through the Lens of John Dewey and Benjamin Bloom
  144. How can generative AI intersect with Bloom’s taxonomy?
  145. Bloom’s Taxonomy in the Interaction Between Artificial Intelligence and Human Learning
  146. Bloom’s Taxonomy Revisited
  147. Hva er egentlig problemet med KI og vurdering?
  148. Chat GPT egner seg dårlig til eksamenssensuren
  149. Kunstig intelligens – hemmer eller fremmer det læring?
  150. Exploring interfaces and implications for integrating social-emotional competencies into AI literacy for education: a narrative review
  151. Google Scholar-oversikt over vitenskapelige artikler om ChatGPT og læring (enkelt søk)
  152. Is learning with ChatGPT really learning?
  153. ChatGPT effects on cognitive skills of undergraduate students: Receiving instant responses from AI-based conversational large language models (LLMs)
  154. Cognitive ease at a cost: LLMs reduce mental effort but compromise depth in student scientific inquiry
  155. Did the COVID-19 pandemic lead to an increase in academic misconduct in higher education?
  156. Pressure to Plagiarize and the Choice to Cheat: Toward a Pragmatic Reframing of the Ethics of Academic Integrity
  157. Why the Architects of Modern AI Do Not Think LLMs Lead to AGI
  158. How Your Cheese-Powered Baby Trounces AI
  159. Mener folk bruker kunstig intelligens feil
  160. Artificial Intelligence Is Stupid and Causal Reasoning Will Not Fix It
  161. AI Is No Match for the Quirks of Human Intelligence
  162. No, AGI is NOT here and won’t be for 20 YEARS at least
  163. Current AI models a ‘dead end’ for human-level intelligence, scientists agree
  164. 15 ting ChatGPT ikke klarer
  165. Myter om hva generative språkmodeller kan og ikke kan brukes til i arbeid med tekst
  166. KI-debatten må ned på bakken
  167. ChatGPT is not OK! That’s not (just) because it lies
  168. ChatGPT can’t think – consciousness is something entirely different to today’s AI
  169. One year on: has ChatGPT really changed the game?
  170. AI: A Guide for Thinking Humans
  171. Marcus on AI
  172. AAAI 2025 Presidential Panel on the Future of AI Research
  173. Khrono sin KI-skole
  174. Futurism sine artikler om AI
  175. ChatGPT and other language AIs are nothing without humans – a sociologist explains how countless hidden people make the magic
  176. The Illusion of Thinking: Understanding the Strengths and Limitations of Reasoning Models via the Lens of Problem Complexity
  177. This is the beginning of the end of the generative AI boom
  178. The most powerful takedowns of generative AI, from those who know its impacts best
  179. Hva skal mennesket drive med hvis KI tenker for oss?
  180. Climbing towards NLU: On Meaning, Form, and Understanding in the Age of Data
  181. Sentient AI will never exist via machine learning alone
  182. Kan generativ kunstig intelligens opplyse og danne oss?
  183. KI er en fristelse som er umulig å motstå. Våre barn er hardest rammet
  184. Will Artificial Intelligence Get in the Way of Achieving Gender Equality?
  185. Dårlig AI-generert kode skaper trøbbel: «Hører mer og mer om det»
  186. Chat GPT – vår tids «Titanic»?
  187. KI endrer internett – og fyller det med «søppel»
  188. Ekspert tror KI-visjoner er overdrevne
  189. Er ChatGPT og andre AI-tjenester en revolusjon?
  190. Bruk av generativ kunstig intelligens i offentlig sektor
  191. ChatGPT struggles to answer medical questions, new research finds
  192. DUAL NATURE OF GENAI: CATALYST OR BARRIER FOR CRITICAL THINKING AND PROBLEM-SOLVING SKILLS? A SYSTEMATIC REVIEW
  193. Why the AI Debate Often Misses the Point
  194. Kunstig intelligens kan gjøre Norge dårligere på it
  195. The Neuroscience Behind 5 Human Abilities AI Still Cannot Replace
Digital dømmekraft – Små valg. Store konsekvenser

Dette innlegget er del av fokuset på den nasjonale sikkerhetsmåned 2026 i egen undervisning

Innledning

«Hvert sekund tar vi valg på nett. Vi klikker på lenker, godkjenner tilganger, deler informasjon og svarer på meldinger – ofte uten å tenke oss om.»

NorSIS, Sikkerhetsmåneden 2026

Det er sjelden at et sikkerhetstema treffer så presist som årets. For digital dømmekraft er ikke et abstrakt begrep, men en helt konkret ferdighet vi alle bør utøve hver eneste dag. Og i en tid der sosial manipulering, kognitiv krigføring og KI‑myter har blitt en del av vår digitale virkelighet, er disse små valgene blitt en viktig beredskapsmessig faktor.

Alle vi som underviser, leder, trener og veileder – lærere, forelesere, instruktører i Forsvaret og Sivilforsvaret – står midt i skjæringspunktet mellom teknologi, mennesker og samfunnssikkerhet.

Digital dømmekraft: Den nye basisferdigheten

Digital dømmekraft handler om evnen til å stoppe opp et øyeblikk, vurdere situasjonen og ta et bevisst valg. Det høres enkelt ut. Men i praksis krever det motstand mot tre sterke krefter:

1. Sosial manipulering – den elegante forbrytelsen

Som beskrevet i Påskekriminelt – Sosial manipulering, trenger kriminelle og fiendtlige aktører verken våpen eller datavirus – bare din tillit. Sosial manipulering fungerer fordi den utnytter menneskelige svakheter: hastverk, høflighet, autoritetstro, frykt og nysgjerrighet. Det Katharina Krombholz, Heidelinde Hobel, Markus Huber og Edgar Weippl gjennomgår i pensumartikkelen «Advanced Social Engineering Attacks» fra 2014 er like aktuelt i 2026.

Når 80 % av voksne nordmenn bruker sosiale medier daglig, og når barn og unge får nyhetene sine fra TikTok, Snapchat og YouTube, er det ikke rart at manipulasjon har blitt en lavterskeltrussel. Små valg, som det å klikke på en lenke, svare på en melding eller dele et bilde, kan åpne døren for store konsekvenser.

2. Sosiale medier som krigsskueplass

Innlegget Fra lek og læring til krigsskueplass viser hvordan sosiale medier har blitt en arena for kognitiv krigføring. Algoritmer er ikke nøytrale; de er designet for å påvirke oppmerksomhet, følelser og adferd. Når diktaturstater bruker TikTok som psykologisk operasjonsplattform, er det ikke lenger bare «innhold» vi scroller gjennom, det er påvirkning.

Digital dømmekraft betyr å forstå at det du ser eller leser, ikke nødvendigvis er det som er sant, viktig eller tilfeldig.

3. KI‑mytene som svekker dømmekraften

I Den farlige drømmen om KI beskrives hvordan samtaleroboter som ChatGPT og Copilot ofte tillegges egenskaper de ikke har. Når både media og politikere omtaler statistiske tekstgeneratorer som «intelligente», skapes en teknologisk analfabetisme som gjør oss mer sårbare.

Digital dømmekraft betyr å vite hva samlebegrepet «KI» egentlig innebærer, og hva det ikke innebærer. Det betyr å forstå at en samtalerobot ikke har innsikt, ikke har intensjoner og ikke har forståelse. Den kan hjelpe deg med formuleringer, men den kan ikke ta beslutninger for deg. Å overlate dømmekraft til en maskin er ikke bare faglig svakt – det er en sikkerhetsrisiko.

Hvorfor dette er kritisk for lærere, instruktører og befal

Vi som underviser og trener andre, står i en særstilling. Ikke bare skal vi beskytte oss selv, vi skal også lære bort dømmekraft til andre. Og i en tid der både barn, unge og voksne lever i en digital virkelighet som er mer manipulerende enn informativ, er dette en del av samfunnsberedskapen.

Digital dømmekraft er ikke bare en individuell ferdighet. Det er en kollektiv motstandskraft.

Tre områder der små valg får store konsekvenser i deres arbeid:

  • Undervisning: Elevene deres bruker såkalte «KI‑verktøy», sosiale medier og digitale plattformer ukritisk. De trenger veiledning i å forstå teknologien, ikke bare bruke den. Barn og unge er ikke født med kunnskap om det digitale. De er først og fremst superkonsumenter av digitale medier (som resten av befolkningen).
  • Beredskap og sikkerhet: Forsvaret, Sivilforsvaret, politiet og andre beredskapsetater, samt skoleverket og universitetssektoren, er mål for påvirkning, desinformasjon og sosial manipulering. Et feil klikk kan gi innsyn i systemer, rutiner eller personell.
  • Profesjonell rolle: Som fagpersoner er dere autoriteter. Når dere deler, liker, kommenterer eller videreformidler digitalt innhold, påvirker dere andre, og kan selv bli utnyttet.

Digital dømmekraft i praksis: Fem refleksjoner

Dette er ikke en sjekkliste, men en mental holdning:

1. Stopp opp før du klikker

Hastverk er den største sårbarheten i digital adferd.

2. Spør: «Hvem tjener på at jeg tror dette?»

Et enkelt spørsmål som avslører mye av den kognitive krigføringens mekanikk, så vel som kommersielle aktørers reklamefremstøt knyttet til sekkebegrepet KI.

3. Ikke la teknologi tenke for deg

Såkalt «KI» kan være nyttig, men er kun programlinjer fokusert på bl.a. statistisk analyse av tekst og kan ikke tenke eller foreta kloke valg.

4. Vær bevisst på hva du deler

Informasjon om deg, dine barn, dine kolleger eller din arbeidsplass er råmateriale for manipulasjon.

5. Tren dømmekraft som en ferdighet

Digital dømmekraft er ikke medfødt. Den må øves i klasserommet, via større eller mindre beredskapsøvelser, i hverdagen både på jobb og ved kjøkkenbordet.

Konklusjon: Dømmekraft er vår viktigste digitale beredskap

I 2026 er ikke den største digitale trusselen avansert teknologi. Det er menneskelig uoppmerksomhet.

Digital dømmekraft er evnen til å ta små valg som hindrer store konsekvenser. Det er evnen til å gjennomskue manipulasjon, motstå påvirkning, forstå teknologi og handle med bevissthet.

For dere som underviser, leder og trener andre, er dette ikke bare et personlig ansvar men en profesjonell plikt. For digital dømmekraft er ikke kun en ferdighet. Det er en del av samfunnets motstandskraft mot aktører som ikke vil oss vel.

«We have designed our civilization based on science and technology and at the same time arranged things so that almost no one understands anything at all about science and technology. This is a clear prescription for disaster.»

Carl Sagan, 1995

Leselist

  1. Kevin Mitnick: The Art of Deception
  2. NorSIS: Sosial manipulering – den menneskelige faktoren
  3. Beyond data Why culture and human judgement matter for institutions in the age of AI
  4. Humans as the Main Social Engineering Target
  5. Kritisk tenkning: teori og forskning
  6. We’re Failing the AI IQ Test

KI‑optimismens drømmerier kontra kritiske perspektiv forankret i den teknologiske virkelighet

«Universiteter liker å omtale kritisk tenkning som sitt fremste læringsutbytte. Likevel har store deler av KI-debatten handlet om hvordan vi kan hindre studenter i å bruke verktøyet, snarere enn hvordan vi kan undersøke om studentene faktisk tenker kritisk når de bruker det. Det er en merkelig diskusjon. Kanskje skyldes det at universiteter i mange år har vært flinkere til å måle svar enn til å måle dømmekraft.»

Bilal Sheikh, 2026 (1)

Debatten om kunstig intelligens i høyere utdanning er i ferd med å dele seg i to spor: ett der teknologioptimismen får dominere, og ett der kritiske perspektiver forsøker å holde fast ved forskningens og demokratiets grunnleggende prinsipper.

Et godt bilde på teknologioptimismen, og motstand mot mer kritiske røster, er Anders Eidsvik sitt innlegg på Altinget.no. Her hevder han at førsteamanuensis Inga Strümkes kritiske røst i KI-debatten er en bjørnetjeneste.

Eidsviks argument bygger på et premiss om at KI-utviklingen er så uforutsigbar og rask at vi må være åpne for alt – også det vi ikke forstår. Men dette er en farlig form for pragmatisme som overser det enkle vitenskapelige faktum at datamaskiner fortsatt er datamaskiner.

Datamaskiner er stadig vekk basert på digitale, binære «byggesteiner», ikke mystisk og uforklarlig magi. Siden 2022 har vi fått flere og mer spesialiserte verktøy (akseleratorer, minnetyper, DPUs, kjøleløsninger) for å møte behovene skapt av store språkmodeller, men disse endringene er forbedringer av samme grunnleggende prinsipp. Datamaskiner er fortsatt digitale maskiner som bruker binær logikk (0 og 1) i form av elektriske tilstander og begrensningene som følger av fysikk, strøm, kjøling og nettverk er ikke på mystisk vis plutselig opphevet.

Dette betyr at vi stadig er låst til de samme fysiske realitetene som vi har vært i flere tiår. OpenAI, Microsoft og andre kommersielle aktører har ikke funnet opp hjulet på nytt; de har bare bygget en ekstremt spesialisert versjon av det. Den «magien» vi opplever er et resultat av manglende kunnskap om hvordan datamaskiner faktisk funger, rå datakraft og sofistikert matematikk, ikke et brudd med klassisk datateknologi.

Som informasjonsviter i den samfunnsinformatiske tradisjon etter Rob Kling og Tom Jewett, ser jeg teknologi ikke som nøytral, men som sosialt formet og politisk ladet. «KI» er ikke bare et sekkebegrep som omfatter en rekke ulike digitale system, men også en kulturell kraft som gir ly til kommersielle aktørers påvirkning av hvordan vi lærer, vurderer og forstår verden.

Eidsvik etterlyser fleksibilitet. Jeg etterlyser motstandskraft. Vi må ikke bøye oss for teknologiselskapenes tempo, men stille de vanskelige spørsmålene: Hvem tjener på denne utviklingen? Hva slags kunnskap fremmer den? Og hvilke verdier taper vi?

Universitetenes jobb er ikke å tilrettelegge for ureflektert bruk av store språkmodeller i form av samtaleroboter, men å utdanne borgere med evne til kritisk refleksjon. Det innebærer å utfordre løsningstro, avkle mediefantasier og insistere på forskningens langsomme, men nødvendige tempo. Det innebærer også å la studentene få utforske samtalerobotene som del av deres eksamensarbeider, i de fag der dette er hensiktsmessig sett fra forelesers faglige ståsted.

Strümkes kritikk er ikke en bjørnetjeneste. Den er en demokratisk nødvendighet.

Og initiativet fra en trio ved UiT Norges arktiske universitet – Maria Danielsen, Knut Ørke og Holger Pötzsch – med mål om å få KI-debatten i høyere utdanning inn på et nytt spor, er også en viktig del av en demokratiske prosess mot en større forståelse for fordeler og ulemper ved de digitale system som nå kalles «KI».

Initiativtakerne hevder at KI‑debatten i norsk høyere utdanning er blitt for ensidig optimistisk og at kritiske stemmer ikke slipper til. Forskerne etterlyser en ny retning, der etikk, demokrati, sikkerhet og faglig kvalitet står i sentrum.

Jeg er kanskje ikke uten videre enig i at kritiske stemmer ikke slipper til, selv om det i media (og til dels også internt i akademia) først og fremst fokuseres på tvilsomme påstander om hva samtaleroboter rent faktisk er i stand til og uvitenskapelige fabuleringer om en mulig Isaac Asimov-lignende fremtid.

Men vi trenger en kritisk og faglig debatt om sekkebegrepet «KI», og ikke minst om de konkrete (og begrensede) verktøy som siden 2022 har gitt støtet til en teknologisk utvikling som svekker vår individuelle dømmekraft, devaluerer den politiske og kulturelle verdien av selvstendig menneskelig refleksjon og truer demokratiets evne til å skille mellom velfundert kunnskap og glattformulert uvitenhet. Derfor har jeg signert oppropet presentert i Khrono 30. mars 2026.

Frontier AI labs have a strong incentive to tell stories that make AI technology sound more powerful. At their most extreme, they promote science-fiction scenarios of AI “taking over” and causing human extinction. If a technology can replace many employees, surely that technology must be very valuable!

Andrew Ng, PhD (2)

Leseliste

  1. Why AI is not a science
  2. AI as Normal Technology
  3. Jagged Intelligence – The dangerous unknowns at the heart of LLMs
  4. Who and What comprise AI Skepticism?
  5. Sterri vs. Strümke
  6. Hype and hope: KI i høyere utdanning
  7. Akademisk skriving med KI i forskning – hva er problemet?
  8. Slutter vi å skrive, slutter vi å lære
  9. I Let an AI Agent Handle a Multi-Step Task. Here’s Where It Broke
  10. Fully Autonomous AI Agents Should Not be Developed
  11. Dette kan være skadelig med KI-modellene, advarer forskere

Hvor står jeg faglig i KI-debatten – og hvem står jeg sammen med internasjonalt?

There tend to be three AI camps. 1) AI is the greatest thing since sliced bread and will transform the world. 2) AI is the spawn of the Devil and will destroy civilization as we know it. And 3) «Write an A-Level paper on the themes in Shakespeare’s Romeo and Juliet.»
I propose a fourth: AI is now as good as it’s going to get, and that’s neither as good nor as bad as its fans and haters think, and you’re still not going to get an A on your report. You see, now that people have been using AI for everything and anything, they’re beginning to realize that its results, while fast and sometimes useful, tend to be mediocre

Steven J. Vaughan-Nichols, 2025 (1)

Jeg anerkjenner store språkmodeller i form av samtaleroboter som kraftige, men begrensede verktøy for tekstgenerering og informasjonsinnhenting. Jeg anerkjenner dem ikke som intelligente aktører. Mitt ståsted er først og fremst forankret i samfunnsinformatikken, slik Rob Kling og Tom Jewett praktiserte dette fagområdet, og derigjennom rotfestet i internasjonal kritisk KI-tenkning. Jeg bekjenner meg altså til en tradisjon som setter menneskelig dømmekraft, læring og samfunnsansvar foran teknologisk begeistring.

Hvorfor jeg er skeptisk til sekkebegrepet «KI»

«Så hva er kunstig intelligens? Først og fremst er det et gammelt fagfelt med et misvisende navn. Som helhet har fagfeltet vært en skuffelse, fordi ordet «intelligens» antyder et løfte disse løsningene aldri har vært i nærheten av å innfri. Samtidig er ideer derfra blitt brukt til å lage IT-løsninger i flere tiår.»
– Bjørn Stærk, 2023 (2)

De siste årene har jeg brukt mye tid på å teste samtaleroboter som ChatGPT, Copilot og lignende system – ikke bare som nysgjerrig teknolog, men som undervisningsforsker og samfunnsinformatiker. Erfaringen er ganske klar: Det vi i dag kaller «KI» i offentligheten, er først og fremst statistiske tekstgeneratorer. Sekkebegrepet «KI», slik det benyttes i dagens debatt, skaper mer forvirring enn innsikt.

Når jeg sier at samtaleroboter av typen ChatGPT ikke er eksempler på kunstig intelligens, er det ikke fordi jeg vil være kontrær for artighets skyld. Det handler om noe langt mer grunnleggende; ordene vi bruker, former forventningene våre. Kaller vi statistiske tekstgeneratorer for «intelligente», inviterer vi til misforståelser – både faglig, politisk og pedagogisk.

Samtaleroboter er kraftige verktøy, men ikke tenkende aktører som utfordrer etablerte pedagogiske praksiser

«Språkmodeller er lagd for å skrive gode setninger, ikke for å undersøke virkeligheten»

– Førsteamanuensis Inga Strümke, 2025 (3)

Samtaleroboter er imponerende på én ting; de er ekstremt gode til å beregne hvilke ord som sannsynligvis passer etter hverandre, gitt enorme mengder treningsdata. De er derimot ute av stand til å forstå, vurdere eller reflektere.

For meg er det derfor mer presist å omtale disse systemene som:

  • Samtaleroboter – fordi de simulerer dialog
  • Statistiske tekstgeneratorer – fordi de i bunn og grunn driver med sannsynlighetsberegning over tekst

Disse systemene

  • analyserer ikke oppgaven slik en student gjør
  • vurderer ikke kildenes kvalitet
  • resonnerer ikke over konsekvenser eller logisk konsistens
  • har ingen forståelse av sannhet

«Unlike hallucinations, which introduce false-hoods, sycophancy is a bias in the selection of the data people see. When AI systems are trained to be helpful, they may inadvertently prioritize data that validates the user’s narrative over data that gets them closer to the truth.»

– Rafael M. Batista, PhD and Professor Thomas L. Griffiths, 2026 (4)

Så når vi omtaler disse digitale systemene som «intelligente», er det lett å glemme at alt de gjør, er resultat av menneskelig programmering, menneskelig data og menneskelig tolkning.

«Intelligensen» er altså kun en illusjon skapt av statistiske mønstre, der det verken forekommer analyser, vurdering eller faktaforståelse. Og når samtaleroboter produserer tekster som forsterke brukerens antakelser, fordommer og ønskedrømmer så er dette ikke resultat av en villet handling basert på kognitive prosesser. Det er ren statistikk.

Derfor bør vi møte denne spesifikke teknologien med nøkternhet i akademia og bruke den som et begrenset verktøy der det gir konkret verdi, samtidig som vi styrker oppgavedesign, veiledning og vurderingsformer som krever kritisk tenkning, faglig forankring og personlig erfaring. Med andre ord: anerkjenne nytten der den faktisk finnes, men ellers ha fokus på faglige krav, didaktikk og vurderingspraksis forankret i det fagområde vi har ansvaret for.

Slik jeg ser det, må det være den enkeltes undervisningsfilosofi som avgjør oppgavedesign, vurderingsform og hvorvidt samtaleroboter kan brukes som del av studentenes arbeid eller ikke, ikke uvitenskapelige fabuleringer fra KI-fantaster og kommersielle aktører.

Hva samtaleroboter faktisk klarer – og ikke klarer

Today’s large language models are phenomenal at pattern recognition. But they don’t truly understand causality. They don’t really know why A leads to B. They just predict the next token based on statistical correlations.

– Sir Demis Hassabis , 2026 (5)

Når vi skal vurdere hva dataprogram, skapt og driftet av mennesker, kan eller ikke kan, må vi huske på følgende:

Datamaskiner er fortsatt datamaskiner. De er basert på digitale, binære «byggesteiner», ikke mystisk og uforklarlig magi. Siden 2022 har vi fått flere og mer spesialiserte verktøy (akseleratorer, minnetyper, DPUs, kjøleløsninger) for å møte behovene skapt av store språkmodeller, men disse endringene er forbedringer av samme grunnleggende prinsipp. Datamaskiner er fortsatt digitale maskiner som bruker binær logikk (0 og 1) i form av elektriske tilstander og begrensningene som følger av fysikk, strøm, kjøling og nettverk er ikke på mystisk vis plutselig opphevet.

Dette betyr at vi fortsatt er låst til de samme fysiske realitetene som vi har vært i flere tiår. OpenAI, Microsoft og andre kommersielle aktører har ikke funnet opp hjulet på nytt; de har bare bygget en ekstremt spesialisert versjon av det. Den «magien» vi opplever er et resultat av manglende kunnskap om hvordan datamaskiner faktisk funger, rå datakraft og sofistikert matematikk, ikke et brudd med klassisk datateknologi.

Dette utgangspunktet er styrende for min oppfatning av såkalt «KI» og det vi rent faktisk har fått tilgang på – samtaleroboter (som er hovedfokuset her, og i den pågående «KI»-debatten i akademia) og verktøy som genererer bilder, lyd og video basert på LLM‑teknologi.

Mine egne tester av samtalerobotenes evne til å jobbe med arbeidskrav i mine fagemner – basert på påstander om at disse verktøyene kunne skrive alt fra masteroppgaver til vitenskapelige artikler uansett brukerens kunnskapsnivå – , og internasjonal forskning, peker i samme retning:

  • lavere nivå i Blooms taksonomi (reproduksjon, forklaring, oppsummering) kan samtaleroboter levere svar som ser brukbare ut.
  • høyere nivå (analyse, tolkning, vurdering, kritisk refleksjon) faller de gjennom – ofte på spektakulært vis.

Måten KI kommer frem til svarene er at den opererer som slags midtpunkt eller gjennomsnitt av det som allerede sirkulerer av informasjon på internett. Nettopp derfor kan den ikke skape noe genuint nytt, men først og fremst reorganisere det som allerede finnes.

– Erika Eidslott, PhD., 2026 (6)

Derfor bruker jeg ikke KI til vurdering og karaktersetting. Et system som ikke forstår faglig kvalitet, ikke kan skille mellom ekte og falske kilder, og som ikke kan redegjøre for egen «tenkning», er etter mitt syn uegnet som vurderingsinstans. Det betyr ikke at verktøyene er ubrukelige, men at de må brukes som nettopp det – verktøy, ikke faglige sensorer.

Mitt internasjonale faglige slektskap

In the literal sense, the programmed computer understands what the car or the adding machine understand: namely, exactly nothing.

—John Searle, 1980 (7)

Som samfunnsinformatiker med fokus på Human‑Centric Security, med over 30 års erfaring med faglig og underholdningsmessig bruk av informasjonsteknologi – både som IT-sjef, gamer, underviser og undervisningsforsker – og med mer enn 20 års erfaring med studentaktiv og nettbasert undervisning, har jeg plassert meg i kretsen av nasjonale og internasjonale akademikere som er kritiske til hvordan begrepet «KI» brukes i offentligheten. 

Jeg står altså ikke alene i mitt syn på at samtaleroboter ikke er strålende eksempler på «KI». Tvert imot befinner jeg meg i et ganske tydelig internasjonalt landskap av forskere og fagmiljøer som:

  • kritiserer hypen rundt «KI»
  • avmystifiserer LLM-er
  • insisterer på at vi må skille mellom statistisk mønstergjenkjenning og intelligens

Blant dem finner vi:

I utdanningsfeltet står jeg nær forskere som Neil Selwyn, Audrey Watters og Jeffrey Bilbro, som har vist hvordan «revolusjonerende» læringsteknologi gang på gang ender som moderate verktøy – ofte med merarbeid og nye former for avhengighet, men uten den lovede læringsgevinsten.

Når jeg plasserer meg selv i dette internasjonale landskapet, er det fordi jeg kjenner meg igjen i tre felles kjennetegn:

  1. Teknologirealisme: Verken demonisering eller ukritisk begeistring, men nøktern analyse av hva systemene faktisk gjør.
  2. Begrepskritikk: Motstand mot å bruke «intelligens» om systemer som ikke forstår, ikke resonnerer og ikke har mål eller intensjoner.
  3. Fokus på menneskelig læring og dømmekraft: Teknologi skal støtte, ikke erstatte, menneskelig tenkning – særlig i utdanning.

Hvorfor er det viktig med et kritisk blikk?

From a critical analytical perspective, the idea that human and machine intelligence can and should be compared is equally problematic because it creates a false equivalence between human decision-making and computer decision-making. This false equivalence can become the basis for a series of dubious practices, such as the replacement of (fallible) human judgement with (allegedly superior, but no less fallible) machine judgement.

– Cristobal Garibay-Petersen, Marta Lorimer and Bayar Menzat, 2026 (8)

I norsk utdanningsdebatt brukes «KI» nå om alt fra stavekontroll til samtaleroboter. Og i ulike styredokumenter ol. som skal danne grunnlag for bruk av digitale verktøy i høyere utdanning, ser vi altfor ofte påstander av typen «forventes å påvirke universitetets kjerneoppgaver». Men denne og lignende påstander forankres ikke i forskning, men i vage henvisninger til «debatten» eller til ulike mediehistorier.

Men universiteter skal ikke forankre sin politikk i vage og sprikende «debatter», men i forskning. Når såkalt «generativ KI» fremstilles som en uunngåelig revolusjon, er dette synsing ikke evidensbaserte fakta og et symptom på at vi mangler ikke bare et presist språk men en grunnleggende forståelse for teknologi.

For meg er dette ikke bare en faglig irritasjon, men et demokratisk spørsmål. Hvis vi ikke klarer å skille mellom:

  • verktøy som hjelper oss å skrive litt raskere, og
  • systemer som faktisk kan ta autonome beslutninger med reelle konsekvenser

– da gjør vi oss selv sårbare. Ikke for «den onde KI-en», men for mennesker og institusjoner som bruker teknologien til å styre, manipulere og effektivisere på måter vi ikke fullt ut forstår.

Oppsummert

That tech fantasy is running on fumes. We all know it’s not going to work. But the fantasy compels risk-averse universities and excites financial speculators because it promises the power to control what learning does without paying the cost for how real learning happens. Tech has aimed its mid revolutions at higher education for decades, from TV learning to smartphone nudges. For now, A.I. as we know it is just like all of the ed-tech revolutions that have come across my desk and failed to revolutionize much. Most of them settle for what anyone with a lick of critical thinking could have said they were good for. They make modest augmentations to existing processes. Some of them create more work. Very few of them reduce busy work.

– Professor Tressie McMillan Cottom, 2025 (9)

Slik jeg ser det er det min jobb (og plikt) som teknolog og fagperson ved et universitet å

  • ikke omtale samtaleroboter som intelligente – men heller beskrive dem som det de er: statistiske tekstgeneratorer
  • bruke dem som pedagogiske case, ikke som fasit – særlig for å trene kritisk tenkning, kildekritikk og forståelse av hva teknologi kan og ikke kan
  • styrke teknologiforståelse og vitenskapelig allmenndannelse – slik at både studenter og beslutningstakere kan gjennomskue medieskapte fantasier
  • diskutere KI som ordinær teknologi, på linje med andre digitale verktøy – med nytte, risiko og begrensninger på bordet samtidig

Til syvende og sist handler ikke KI‑debatten om hva kommersielle aktører og enkelte håpefulle forskere påstår at teknologien kan gjøre, men om vår evne til å bevare et presist språk, en kritisk dømmekraft og et utdanningssystem som fortsatt setter menneskelig forståelse høyere enn statistisk etterligning.

Når vi avmystifiserer samtaleroboter og plasserer dem der de hører hjemme – som kraftige, men grunnleggende begrensede verktøy – muliggjør vi en mer ærlig og kunnskapsbasert samtale om hva slags læring, samfunn og demokrati vi ønsker å bygge. Det er i dette landskapet jeg står, sammen med akademikere som insisterer på realisme fremfor hype, begrepsklarhet fremfor markedsretorikk og menneskelig dømmekraft fremfor teknologisk fatalisme.

Skal vi navigere videre på fornuftig vis, må vi ikke spørre hva «KI» kan gjøre for oss, men hva vi som samfunn risikerer å miste dersom vi slutter å forstå hva vi faktisk gjør.

Once men turned their thinking over to machines in the hope that this would set them free. But that only permitted other men with machines to enslave them.

Frank Herbert, Dune, 1965

Leseliste

  1. Kritisk front mot KI i offentlig sektor
  2. Debunking AI Myths: What’s Hype, What’s Real, and Why It Matters
  3. AI Isn’t What You Think — It’s Just What Computers Can’t Do (Yet)
  4. Large Language Model Reasoning Failures
  5. Vision Language Models Are Blind
  6. MIRAGE: The Illusion of Visual Understanding
  7. Alarming Study Finds That Most People Just Do What ChatGPT Tells Them, Even If It’s Totally Wrong
  8. AI as Normal Technology
  9. On the Dangers of Stochastic Parrots: Can Language Models Be Too Big?
  10. GPT-3, Bloviator: OpenAI’s language generator has no idea what it’s talking about
  11. Why AI is Harder Than We Think
  12. AI Snake Oil: What Artificial Intelligence Can Do, What It Can’t, and How to Tell the Difference
  13. Nei, KI-agenter driver ikke med sverting
  14. Navigating the AI/ML Hype: Applying Carl Sagan’s Baloney Detection Principles
  15. The Ethics of AI in Education
  16. The AI We Deserve
  17. Who and What comprise AI Skepticism?
  18. Why AI is not a science
  19. Om kunstig intelligens
  20. The history of artificial intelligence, Del 1, Del 2 og Del 3
  21. Understanding the different types of artificial intelligence
  22. Artificial intelligence: How is it different from human intelligence?
  23. Viewpoint: When Will AI Exceed Human Performance? Evidence from AI Experts
  24. Dear laymen, here’s what you got wrong about AI or LLM

Myten om de digitale innfødte

Perhaps the most persistent barrier to effective digital education is the myth of the digital native: the notion that young people possess innate technological fluency simply by virtue of their birth year. This concept, coined in 2001 to describe people born after 1980, has outlived any usefulness it might once have claimed. It is now actively harmful. It suggests that digital competence is inherited rather than taught, that wisdom about technology arrives automatically with youth, that schools need not cultivate digital discernment because young people already possess it. They do not.

Laura Knight, 2025 (1)

At begrepet «Digitale innfødte» er en myte uten forskningsmessig forankring burde være velkjent i akademia, men jeg støter stadig på dette som en begrunnelse for hvorfor vi som forelesere i UH-sektoren bør bruk digitale «verktøy» (et foreldet begrep som snart bør erstattes av «medier»), gjerne etterfulgt av det intetsigende «studentene forventer det».  

En antagelse som ofte blir fremsatt innen utdanningspolitiske utredninger og mer generelt i mediene, er at ungdom og studenter mestrer bruk av digitale kanaler og omgivelser. At ungdom og studenter har mye erfaring med og bruker mange sosiale medier, er det liten tvil om, men å bruke digitale omgivelser til å lære komplisert faglig innhold, er noe helt annet.
– Sten Ludvigsen og Morten Dæhlen, 2022 (2)

Selv ser jeg tydelig i egen undervisning at den generasjonen som per definisjon skulle være «eksperter» på det digitale, først og fremst er konsumenter. I arbeidskrav der studentene utfordres på faglig bruk av ulike digitale verktøy (medier), er det denne generasjonen som oftest har problemer med praktisk bruk av det digitale.

Bruk og kompetanse er ikke direkte sidestilt, og det
finnes mer kunnskap om bruken av digitale verktøy enn
om faktisk digital kompetanse.
– Kompetansebehovsutvalget 2024–2025, (3)

Jeg vil våge følgende påstand: Dagens studenter (med noen unntak – de som bygget sine egne datamaskiner, osv.) er, akkurat som store deler av befolkningen ellers, teknologiske analfabeter. Teknologisk analfabetisme er ikke mangel på evne til å bruke en app, men mangel på forståelse for hva som skjer «under panseret». Og denne manglende forståelsen gir seg negative utslag både i evnen til å bruke digitale verktøy i profesjonell sammenheng og evnen til å ta ansvar for egen digitale beredskap.

Totalt sett ser vi at befolkningen er mindre interessert i teknologi enn tidligere. I 2020 svarte 48% at de var ganske eller svært interessert i teknologi. Årets spørreundersøkelse viser en nedgang siden da, og ligger nå på 43%.
– Norsk senter for informasjonssikring, Rapport 2023 (4)

En forventning om bruk av digitale verktøy fra dagens studenter kan derfor like gjerne være en forventning om at foreleseren skal gjøre det faglige stoffet underholdende eller strømme forelesningene, og er derfor etter min mening helt uvesentlig i en virksomhet der vitenskapelige prinsipp skal danne grunnlaget for det vi gjør. 

Mye av forskningen retter søkelyset mot selve teknologien i undervisningssituasjoner, mens færre studier vektlegger de pedagogiske og didaktiske perspektivene.
– Fra DIGITEK-HU samlerapport, 2025 (5)

Som teknolog med over 20 års undervisningserfaring fra både campus-baserte fag, og rene asynkrone nettstudier, tilknyttet samfunnsinformatikk-området, var – og er – bruk av digitale medier en selvfølge. Men dette er knyttet til mitt fagområde og min undervisningsfilosofi. Fokuset er på det pedagogiske og didaktiske, ikke på vage ideer om hva studentene forventer og fantasier om «digitale innfødte» eller – enda verre – «KI-innfødte».

Det er blitt vanlig å omtale unge som «digitalt innfødte». Det er en sannhet med betydelige forbehold. Mange navigerer sosiale medier og underholdningsplattformer med stor letthet. Men når det gjelder digitale ferdigheter som kreves i studier og arbeidsliv, er kompetansen ofte overraskende svak.
– Universitetslektor Trond Olav Skevik, 2026 (6)

Når våre politikere har som uttalt mål at Norge skal være verdens mest digitalisert land i 2030 er et av flere viktige steg å anerkjenne at reell digital kompetanse er noe man lærer som del av foreldres oppdrager/ veiledervirksomhet, skoleverkets undervisning både i basiskunnskaper og i bruk av digitale medier, samt høyere utdannings fokus på faglig bruk av det digitale.

Dette er ikke noe man er født med eller på mystisk vis tilegner seg kun ved ukritisk konsumentbruk av smartmobiler, nettbrett og sosiale medier.

Leseliste

  1. Death to the Digital Native
  2. Jeg får pulsen opp hver gang noen sier at barn og unge er digitalt innfødte
  3. En myte at barn er «digitalt innfødte»
  4. Are digital natives a myth or reality? University students’ use of digital technologies
  5. Challenging the Myth of the Digital Native: A Narrative Review
  6. Myten om digitale innfødte: virkelighet eller fiksjon?
  7. «Digitalt innfødte» og skolen
  8. Lagging digital literacy among 14-year-olds across the EU, study finds
  9. Are we facing a generational decline in digital literacy?
  10. DigComp 2.2: The Digital Competence Framework for Citizens – With new examples of knowledge, skills and attitudes

Når over 20 år gamle digitale verktøy, og enda eldre praksis, omtales som «nye»…

Illustrasjon generert av Microsoft Copilot

«Historically, AI researchers’ predictions about progress in AI abilities have been pretty bad. We don’t really have principles that describe which kinds of tasks are easy for AI and which ones are hard»

Professor Arvind Narayanan, 2026 (1)

Samlebetegnelsen «KI» er stadig i vinden, og med utgangspunkt i samtaleroboter av typen ChatGPT, Copilot osv. er det ikke måte på hvor store endringer som nå kommer til å skje i de akademiske søylehaller.

I en artikkel på Uniforum fra 28. januar i år, siteres Malthe Sørenssen på at studentene «går frå å hugsa og memorera til å skapa noko sjølve», og at dette krever «nye ferdigheiter» knyttet til bruk av video og podkast. Forutsatt at journalisten har oppfattet Malthe Sørenssen korrekt så viste han altså til bruk av video og podkast som «nye verktøy for studentane».

For mange av oss som har arbeidet med studentaktiv undervisning i informatikk og IKT didaktikk i en årrekke, er det vanskelig å lese dette uten å stusse. Video og podkast som nye verktøy? En overgang fra memorering til skapende arbeid som noe som først skjer nå? Er virkelig kombinasjonen store språkmodeller og samtalegrensesnitt en så fantastisk nyskapende «intelligens» at studentaktiv undervisning og bruk av digitale medier i innholdsproduksjon ved norske universitetsstudier først nå plutselig er blitt gjennomførbart?

Det er mulig at Malthe Sørenssen i den sammenheng som artikkelen refererer til, med hensikt forenklet budskapet for å favne hele spekteret innen UH-sektoren. Men selv har jeg stått i denne utviklingen siden tidlig 2000-tallet, og for meg fremstår slike utsagn litt anakronistiske og kunnskapsløse.

Studentaktiv undervisning er ikke nytt – det er selve grunnmuren i informatikkdidaktikken

«But in a social-issues course, the life experiences and personal values of each student are uniquely relevant to their learning process. Therefore, this type of course places a premium on teaching methods that can build on those life experiences and help to clarify and strengthen those personal values»
– Tom Jewett, PhD. og Professor Rob Kling, 1996 (2)

I informatikkfagene, og kanskje særlig i den delen som kalles samfunnsinformatikk, har studentaktivitet vært en integrert del av undervisningsdesignet i flere tiår. Her har vi lenge jobbet med:

Dette er ikke eksperimentelle tilnærminger, men moden pedagogisk praksis som er godt dokumentert i både norsk og internasjonal forskning.

Utfordringer med denne type utsagn

«Ifølge rapporten finnes det ingen bevis for at KI forbedrer produktiviteten, pedagogikken eller læringsutbyttet. I mange tilfeller har innføringen av KI heller ført til en negativ utvikling på disse områdene. I motsetning til hva universitetsansatte ofte blir fortalt, har innføringen av KI gjort det akademiske arbeidet tyngre og mindre meningsfullt»
– Professor Holger Pötzsch, universitetslektor Knut Ørke, og forsker Maria Danielsen, 2026 (3)

Det er ikke alltid lett å vite om denne type utsagn som Malthe Sørenssen siteres på er grunnet i ren kunnskapsløshet om andre måter å undervise på enn det man selv gjør, eller om man rett og slett ønsker å løfte frem en (gammel) debatt om forelesninger kontra mer studentaktive metoder. Uansett hensikt, slik utsagn kan skape noen uheldige situasjoner.

  1. Det skapes en udokumentert «sannhet» om at «KI» vil føre til store endringer for hvordan vi underviser og lærer på et universitet.
    Det finnes absolutt ingen vitenskapelige holdepunkt for påstander om at «KI», i uspesifisert form, vil fullstendig endre allerede godt etablert viten om hvordan bedrive læringsaktiviteter i høyere utdanning. Og jo flere ganger denne type «eventyr» gjentas, jo vanskeligere blir det for kritiske fagstemmer å komme til orde. Dette kan fort føre til at utdanningsmyndighetene kjøper ideen om at samtaleroboter er en helt ny og unik «intelligens», og bruker store beløp av skattebetalernes penger til å skaffe helt unødvendige lisenser fra OpenAI eller andre tilbydere til UH-sektoren.
  2. Malthe-Sørensen, i egenskap av utvalgsleder, ønsker å favne hele sektoren, ikke kun fagmiljøer som ligger langt fremme.
    Det finnes selvsagt mange fagområder hvor studentaktiv læring og aktiv bruk av ulike digitale medier til studentproduserte produkt fortsatt er i startfasen, og der det er ønskelig at prosessen mot andre undervisningsmetoder får en noe større fart. Men slike utsagn kan oppfattes som generalisering av hele UH sektoren, og dermed skape et feil bilde av hvor langt mange fagmiljøer faktisk har kommet og hvor lenge slik bruk av digitale medier har vært standard.
  3. Retorikk som skal skape inntrykk av nytenkning
    Det er kanskje fristende å omtale etablerte praksiser som «innovasjon» for å gi politiske prosesser større fart, og det er i og for seg legitimt. Problemet er at dette fort kan undergrave ulike fagmiljøers reelle utviklingsarbeid, som gjerne har pågått i tiår.
  4. Et gap mellom utvalgets verden og faktisk undervisningspraksis
    Når en utvalgsleder beskriver en utdanningsvirkelighet frakoblet en mer enn 20 års utvikling, kan utvalgets endelige anbefalinger fort bli lite relevante for fagmiljøer som alt lenge har fokusert på «learning by doing». Dette minner om den gang NTNU-professor Arne Krokan begynte med MOOC i 2012 og media og politikere ojet seg over dette fantastiske nye kalt «E-læring» eller «Nettbasert undervisning», og glemte at dette var noe norske utdanningsmiljø hadde holdt på med siden 1987.

Et utvalg som risikerer å ikke treffe praksisfeltet

«Språkmodeller modellerer ikke virkeligheten, de modeller språk. De lager ikke tekst basert på fakta og årsakssammenhenger, de lager tekst som ser ut som om den kan være riktig»
– Professor Jill Walker Rettberg, 2025 (4)

Når en leder for et offentlig utvalg omtaler video og podkast som «nye verktøy», sender det et signal om at man ikke har oversikt over den pedagogiske utviklingen som faktisk har skjedd i store deler av UH-sektoren. For undervisere som daglig jobber med studentaktive, skapende læringsformer, kan dermed KI-utvalget fort fremstå som lite relevante selv om Malthe Sørenssen sine uttalelser ikke nødvendigvis gir et bilde av utvalgets samlede arbeid per nå eller hva de endelige anbefalingene vil bli.

Det er godt mulig at det i deler av UH‑sektoren fortsatt er slik at studentaktiv læring og bruk av digitale medier til innholdsproduksjon er «nytt» og under innfasing, men en utvalgsleder som skal peke ut retningen for fremtidens utdanning bør ha – og vise – god kunnskap om nåtiden. Hvis ikke risikerer vi at politiske anbefalinger blir basert på en virkelighet som kun eksisterer i de mest nedstøvede akademiske elfenbenstårn.

Avslutning

«Part of our response to GenAI in education needs to be squarely centred on a simple question – what do we want the benefits of our education to be? If it is “to be good at writing prompts for ChatGPT” then so be it but I would guess that it’s not. We want graduates that are skilled enough that should they actually find use in GenAI in the world of post-degree work, they will be the type of adaptable, capable people who can quickly pick up the tool and get going with it»
– Jeremy Moulton, PhD., 2025 (5)

Når vi omtaler godt over 20 år gamle praksiser og verktøy som «nye», mister vi ikke bare en helt nødvendig presisjon, men vi mister også muligheten til å diskutere de faktiske utfordringene i høyere utdanning, der såkalt «KI» i form av «samtaleroboter» bare er en liten del av et større hele.

Det er derfor på høy tid at de som skal stå for nye utdanningspolitiske prosesser tar inn over seg at for mange fagmiljøer er studentaktiv læring og utforsking av digitale verktøy gammelt nytt. For disse miljøene er samtaleroboter kun nok et interessant digitalt medie, ikke en mystisk «intelligens» som kaster overbord veletablerte pedagogiske metoder og vurderingspraksiser.

«That tech fantasy is running on fumes. We all know it’s not going to work. But the fantasy compels risk-averse universities and excites financial speculators because it promises the power to control what learning does without paying the cost for how real learning happens. Tech has aimed its mid revolutions at higher education for decades, from TV learning to smartphone nudges. For now, A.I. as we know it is just like all of the ed-tech revolutions that have come across my desk and failed to revolutionize much. Most of them settle for what anyone with a lick of critical thinking could have said they were good for. They make modest augmentations to existing processes. Some of them create more work. Very few of them reduce busy work.»
– Professor Tressie McMillan Cottom, 2025 (6)

Redigert: 03.02.26

Leseliste

  1. Learning by Doing – the Way to Develop Computer Science Professionals
  2. LEARNING BY DOING: TWENTY SUCCESSFUL ACTIVE LEARNING EXERCISES FOR INFORMATION SYSTEMS COURSES
  3. Active learning increases student performance in science, engineering, and mathematics
  4. A review of podcasting in higher education: Its influence on the traditional lecture
  5. Smart Learning in the 21st Century: Advancing Constructionism Across Three Digital Epochs
  6. Active Learning Strategies in Computer Science Education: A Systematic Review
  7. How are we doing with student-centered learning facilitated by educational technologies? A systematic review of literature reviews
  8. Promoting computational thinking through project-based learning
  9. Constructivism in Computer Science Education
  10. Motivational Active Learning – Engaging University Students in Computer Science Education
  11. Does the Flipped Classroom Improve Student Learning and Satisfaction? A Systematic Review and Meta-Analysis
  12. Student-Produced Podcasts as a Teaching and Learning Tool
  13. NOU 2014: 5 – MOOC til Norge Nye digitale læringsformer i høyere utdanning
  14. The GenAI Divide – STATE OF AI IN BUSINESS 2025
  15. Artificial Intelligence and Academic Professions

Hvorfor jeg ikke benytter KI til vurdering og karaktersetting

Today’s large language models are phenomenal at pattern recognition. But they don’t truly understand causality. They don’t really know why A leads to B. They just predict the next token based on statistical correlations.

Sir Demis Hassabis , 2026 (1)

Som samfunnsinformatiker med fokus på Human‑Centric Security har jeg plassert meg i kretsen av nasjonale og internasjonale akademikere som er kritiske til hvordan begrepet «KI» brukes i offentligheten. Og jeg har i andre innlegg påpekt at ChatGPT og lignende samtaleroboter ikke er intelligente og dermed heller ikke klare eksempler på KI.

«Så hva er kunstig intelligens? Først og fremst er det et gammelt fagfelt med et misvisende navn. Som helhet har fagfeltet vært en skuffelse, fordi ordet «intelligens» antyder et løfte disse løsningene aldri har vært i nærheten av å innfri. Samtidig er ideer derfra blitt brukt til å lage IT-løsninger i flere tiår.»
– Bjørn Stærk, 2023 (2)

I tittelen på dette innlegget har jeg likevel valgt å benytte forkortelsen «KI» siden dette begrepet stadig brukes i media og i akademia, selv om det åpenbart kun er samtaleroboter – store språkmodeller i forbindelse med samtalegrensesnitt – det egentlig skrives om.

I desember 2025 la Malthe-Sørenssen-utvalget frem en første betenkning, der et av rådene er å bruke «KI» til sensurarbeid. For meg er det totalt uaktuelt å følge en slik oppfordring, og begrunnelsene for det er følgende:

Teknisk

«Språkmodeller er lagd for å skrive gode setninger, ikke for å undersøke virkeligheten»
– Førsteamanuensis Inga Strümke, 2025 (3)

Som mine ulike feltobservasjoner fra praktiske tester av et utvalg samtaleroboter gjennomført i perioden 2022–2025 viser, er disse verktøyene ikke i stand til å levere gode besvarelser på eksamensoppgaver utformet i tråd med høyeste nivå i Blooms taksonomi.

Jeg har i løpet av 2025 også foretatt tester av hvorvidt samtaleroboter kan foreta vurdering av studentbesvarelser. Tekster strippet for alle henvisninger til studentidentifikasjoner ble lastet opp, sammen med omfattende sensorveiledninger og den kvalitative beskrivelsen av karaktersystemet for universitets- og høgskolesektoren.

Til tross for omfattende «promting» ble resultatet like ubrukelig som forventet. Statistiske beregninger designet for å finne mønstre er uegnet til å vurdere studenters evne til analyse, syntese og evaluering knyttet til helt spesifikt fagstoff og til egen yrkesvirkelighet, evne til å reflektere over egen læring og evne til å finne gode (og etterprøvbare) fagkilder for å bygge opp under egne faglige refleksjoner. De statistiske beregningene hadde selvsagt heller ingen mulighet til å vurdere en students faglige progresjon fra første utkast levert til veiledning til endelig innlevering av en fullstendig fagtekst kombinert med praktisk verktøybruk (utforming av dataspill, digitale læringsrom i et LMS, osv.).

Som teknolog med kunnskap om hvordan slike system rent faktisk fungerer, var det negative resultatet ikke særlig overraskende.

Det juridiske

«Men de overser forvaltningsrettens dypere kommunikative rasjonale: Hvor mye av sensors vurdering kan bli erstattet av KI før man kommer på kant med forvaltningens evne til å kommunisere?»
– Førsteamanuensis Tarjei Ellingsen Røsvoll, 2025 (4)

Det begynner å bli mange år siden jeg, som student ved Offentlig rett i Bergen, hadde gleden av å oppleve professor Arvid Frihagen sine ytterst inspirerende forelesninger i forvaltningsrett. Og det er også lenge siden jeg underviste informatikkstudenter i de deler av forvaltningsretten som hadde direkte relevans for de som senere skulle ut i jobber som IT-sjef eller systemansvarlig.

Men når jeg leste Malthe-Sørenssen-utvalget sine tanker om å overlate sensuren til et digitalt system, var det første som slo meg at dette kunne umulig være i tråd med norsk rett.

I forvaltningsretten har vi noe som heter «forvaltningens menneskelige ansikt», og slik jeg ser det er bruken av samtaleroboter til sensur et klart brudd på studentenes soleklare rett til at all vurdering av deres arbeid er utført av en fagperson som så kan forankre og begrunne karaktersettingen i eget faglige skjønn, slik det har kommet til uttrykk i forelesninger, veiledninger og i sensorveiledninger og klart forankret i den generelle, kvalitative beskrivelsen for karakterene A-F i karakterskalaen fastlagt for universitets- og høgskolesystemet.

Det etiske

«AI systems can often operate as «black boxes» in which the decision-making process is opaque. This lack of transparency can undermine trust and make it difficult for educators and students to understand how assessments are determined.»
– Moumita Bhose, 2024 (5)

Når jeg i alle mine fagemner krever at studentene skal løfte fram egne tanker basert på egne erfaringer og faglige refleksjoner, følger det med en etisk forpliktelse: Studentene må kunne forvente at deres arbeider vurderes av meg som fagperson, slik jeg peker på over. Å sette bort karaktersettingen til statistiske beregninger vil kunne svekke tilliten til meg som veileder og fagperson, redusere mitt klare ansvar for seriøs og faglig individuell vurdering, og undergrave hele læringsprosessen.

Konklusjon

Å bruke såkalt «KI» til sensurarbeid kan føre til feilvurdering av komplekse besvarelser, brudd på forvaltningsloven og en alvorlig svekkelse av student-veileder-relasjonen. For meg er dette derfor helt uaktuelt.

Leseliste

  1. Skal teknologien få overta vurderings­arbeidet?
  2. Ikke la prateroboter vurdere elevtekstene dine
  3. Recommendation on the Ethics of Artificial Intelligence
  4. Trustworthy artificial intelligence (AI) in education
  5. Algorithmic Fairness in Automatic Short Answer Scoring
  6. Will AI revolutionise marking?
  7. The digital red pen: Efficiency, ethics, and AI-assisted grading
  8. Automation and Assessment: Exploring Ethical Issues of Automated Grading Systems from a Relational Ethics Approach
  9. The Dangers of using AI to Grade
  10. Don’t use GenAI to grade student work
  11. AI-Assisted Grading: A Magic Wand or a Pandora’s Box?
  12. The Problem with AI Grading
  13. Why AI should not be used in education?
  14. Mitt mareritt er jo at vi bruker KI til å sensurere oppgaver der studentene har brukt KI

Academic Social Media – reaching out to the public, or Maskirovka the Academic Way?

not everything that can be counted counts, and not everything that counts can be counted.

William Bruce Cameron, 1963

Academic social media: game-changer or smoke and mirrors?
We’re told to tweet, post, and share to boost impact—but does it really work? Behind the glossy badges and inflated scores lies a harsh truth: most “engagement” is just academics talking to academics. Add copyright risks, endless profile updates, and metrics you can hack in minutes, and the promise of outreach starts to look like a digital masquerade. Real influence? It still comes from solid research, trusted networks, and meaningful teaching—not chasing likes.

Climbing the Social Media Pole

I’ve been fooling around on Internet since 1994 and most of the time in a professional capacity. Seriously influenced by people like Howard Rheingold, and curiously exploring the various possibilities for academic use of WWW, I’ve built quite a presence online over the years using every Social Media (or Web 2.0 as it was once called) tool as soon as it appeared. But as everyone that have been active users of Internet know, keeping track of multiple profiles, and keeping them alive and updated, is exhaustingly time consuming. At a certain moment, I reached a point where I felt nauseated and tired of everything connected with the Net and withdrew from almost all online tools.

But it is not easy to keep completely away from social media. As a conscripted officer in the Norwegian Civil Defence with staff duties (2013 – 2021) Facebook was the main source of information on what went on within my Civil Defence district. And truth be told; I also missed the online contact with my old team mates from the Home Guard School and Training Centre (2012). So back I went, creating a new profile. As a dean, I had some lecturing so Twitter became, again, a useful tool. But that was it, I thought. No more profiles on the Net.

And then, in 2014, I went back to full time lecturing and everything changed. Because now, having papers publicised in international peer reviewed journals is no longer enough. Our university managers, as well as our lords and masters from the Ministry of Education, speaks of reaching out to a broader audience and that as much as possible of our work are to be open access. And suddenly one is urged to go back on the Net and immerse one selves in various online services.

The tools and all the work that follows

There are infinite possibilities of reaching far and wide using various social media services, and let’s face it; it is difficult to reach out to a large audience from a scientific journal. Not only are these journals mostly read only by our colleagues, but the possibility of having our journal entries cited by fellow researchers are slim. Not because we necessarily write badly or that our work is uninteresting, but because so many of us works within small niches. I have my selves spent most of my academic career pondering how to get computer science students enthusiastic about Social Informatics, or how to motivate students of asynchronously online courses to carry on. While this is important enough for me, and hopefully also for my students, it is neither rocket science nor is it the most popular scientific field in the world. But will enrolling in various Social Media services help you to reach out to a larger audience? Not necessarily.

Let’s have a look at some of the things you might do to be visible as an academic online. Many university managers will point you in the direction of ResearchGate.net and Google Scholar. The last one in order to create an overview of where and how often your papers are cited by others, and the first one because… well, I guess because “everyone else” is there and this is the only academic profiling tool they know of (a part from Google Scholar). So, by creating profiles on these two services, all your troubles are over right? Wrong! To utilise both Google Scholar and ResearchGate demands quite an effort. Like most social media profiles, they need constant updating to stay interesting and/or correct as for your list of publications, and preferably they should be paired with other tools like TwitterORCIDImpactstoryMendeley and Quora. This will increase your online presence and could work favourably as for your so called “impact score”.

ResearchGate have developed into a well-known social networking site for researchers, where they may share papers, ask and answer questions, and find collaborators. In order to use the site, you need to have an email address at a recognized institution or to be manually confirmed as a published researcher in order to get an account. After signing up you create your user profile and might start uploading research papers, data, chapters, presentations, etc. You may also follow the activities of other users and engage in discussions with them, and this way start building a network and perhaps even enter into research cooperation with one or more of your contacts.

Impactstory is an open source, non-profit and web-based tool that provides altmetrics to help researchers measure the impacts of all their research outputs—from traditional ones such as journal articles, to alternative research outputs such as blog posts, datasets, and software. You may use your Twitter account to sign up, but how much this site uses your Twitter activity to measure your impact score is unclear to me. Signing up to Impactstory quicly pushes you to ORCID, as this is the key tool Impactstory uses to gain an overview of your publications. According to ORCID its aim is to aid «the transition from science to e-Science, wherein scholarly publications can be mined to spot links and ideas hidden in the ever-growing volume of scholarly literature». They also give the researcher a possibility to have «a constantly updated ‘digital curriculum vitae’ providing a picture of his or her contributions to science going far beyond the simple publication list».

Mendeley is a desktop and web program produced by Elsevier for managing and sharing research papers, discovering research data and collaborating online, and Twitter I guess does not need much of an introduction. To use Twitter as a dissemination tool you must have followers, preferably many. Your follower count is considered a measure of your influence. The more followers you have, the more you’ll attract, and – in theory – the more you can use your influence to reach your peers, students and other interested parties. But to get followers you have to put in a lot of time of strategic actions, and at the end of the day you might not really know if any of this had any effect or mattered at all. There are no free lunches in the world of Social Media, and just creating some profiles and then sit back and relax is not really an option.

Since all this is mainly about creating and measuring “impact”, utilising digital tools, the more activity you have online, the better. But most of these tools give poor results if you do not already have international papers. So, if you are an academic who so far have been content with focusing on excellent lecturing and close contacts with students, you will have to make quite an effort in order to have any significant use of these tools. And as soon as you have created all these profiles you are trapped in a never ending story of continuously updating them.

The not so open access, legal problems and some unsettling thoughts

ResearchGate strongly encourages its members to upload scientific papers, and many do so. This creates the impression that the platform is an open-access provider. However, there are two major issues with this. First, uploading journal articles usually breaches copyright law. Second, others must sign in to ResearchGate to read these papers. In reality, this makes it a closed-access service, potentially hosting a large number of copyright violations. Academia.edu, a similar social media site, faces the same problems.

A third issue with ResearchGate, when I first wrote about this, was its use of scores. These scores were meant to reflect your “impact”, but the calculation was not transparent, making it hard to understand what data they were based on. Statements like “Your score is higher than 30% of ResearchGate members” encouraged, in my view, an unhealthy focus on questionable metrics and even the possibility of “gaming” the system.

But what does “impact” really mean? Traditionally, we look at journal rankings or how often our work is cited. Sites like ResearchGate and Impactstory aim to create a broader measure of impact, but without clearly defining the term. Would your score rise if you follow researchers with large networks and high RG scores? What if someone visits your profile using a proxy that randomly changes their IP address? Does a mention in a Wikipedia article, written and edited anonymously, truly reflect impact? Would adding a link to your RG profile on Twitter increase visits—and if so, would that affect your RG score? Twitter might drive curious visitors to your profile, but does that mean your work is reaching a wider audience? I don’t think so. A click on a profile link doesn’t necessarily show genuine interest. And who are your Twitter followers—members of the public, or fellow academics and your own students? If it’s the latter, we’re back to the old problem: journal papers being read only by a small circle of peers.

In 2017 some of my metrics looked like this:

  1. Twitter

2. Impactstory:

3. ResearchGate

The statistics for my tweet are rather straight forward, at least to a certain extent. It seems that 180 persons interacted with it in various ways. But of course, on the Net the systems can only count IP-addresses, and therefore what may seem like individual interactions might not necessarily be so. How the number of 9, 357 is figured out is not clear, neither what  «impressions» really entail or why it should matter in the «real world». Impactstory uses the gamification element of badges. Since this tool also focuses on open access, you might get an Open Access badge. I did not get it as I have my papers in ordinary journals, but by uploading a large number of drafts, or even just resumes of papers in for instance ORCID I would not be surprised if Impactstory considers this an adherence to the principles of open access, and award you a badge. And in ReserachGate I achieved the score of 6.49, but have absolutely no clue as to how RG calculated this.

Wanting to understand how ResearchGate counted its impact points in 2017, I repeated the experiment done by professor Kjetil Haugen in 2015. Cloaking my identity using various proxies I viewed my own profile, read and downloaded selected works, and additional shared selected works using one of the Social Media tools RG have made available for this purpose. This was made easy since my selected tool let me share links by simply creating an account with no checking for authenticity. When I started the experiment 1th of March 2017 my RG score was 4, but by the end of the experiment on 10th of March the same year it had increased to 6.49. My conclusion therefore is that nothing has changed since Haugen did his experiment in 2015. In my opinion this renders RG useless as a valid system for measuring individual researchers academic impact. The same goes for Impactstory, and I suspect it will also be true for most of the sites that claims to measure your impact.

My main problem with these Academic Social Media tools is why should these scores matter? They are easy to manipulate, and does not give any real evidence of scientific impact or the individual researchers willingness to be part of the open access movement. Neither do they necessarily give a clear picture of a researcher’s true network. Twitter, who as such is not an Academic Social Media, but might be used as a tool for dissemination, is a great tool to use with students in specific settings, but so far I have found little to prove that my use of it had any impact outside my lectures. But this might be my fault entirely.

Unclimbing and reclimbing the Social Media Pole

Despite (or perhaps because of) having participated in various Social Media for years I again deleted most of my social media profiles in 2017 and 2021. The amount of work you must put into these tools far outweigh any gains they might have and only provides an unnecessary distraction. So far, my most successful international contacts and cooperation’s have been the result of personal acquaintance, not any presence on Academic Social Media.

I re-entered Twitter in 2020 and this time I decided to focus on Preparedness and Cyber Security. My motivation for getting back to Twitter was primarily to keep me informed on various Cyber Security and Preparedness matters. Most of my tweets are done automatically via my Paper.li newspaper.

Looking at my Twitter Analytics two years later, in 2022, I was left with the same question as before; Of what use is this? Twitter has its merits as a tool for discussing topics of interests with other professionals , but not as a tool for dissemination to a broader general public.

Nice that my tweet above got 11 retweets and 17 likes and earned "impressions" but I doubt that it had any impact on parliamentary politicians will to invest in Civil Defence.

Another example of how  a Twitter account tries to create attention to an article is this from Alltinget.no:

According to Alltinget.no my article created a lot of engagement. There is no data on the web page of Alltinget that gives any information verifying the statement. But as we see from the engagement details of this tweet, it did not stir much interest on Twitter.

In May 2024 I again deleted my account on Twitter (now rebranded as X), on the grounds that it had become a «dark» area for constant disinformation and fake news. I had enrolled myself in the work of NAFO, but in the end the whole platform seemed irrelevant as a serious arena for communication and with few or little possibilities for actual combating Russian propaganda.

My profile background picture on Twitter (Now X)

What remains of my social media presence outside blogging is a private account on Instagram, an account on Pinterest (none of them in use, but not deleted), and a Flickr account linked to the Getting Involved project. And I have kept my main YouTube account, but only as documentation of my use of trigger videos in teaching.

In June 2025 I decided to explore Bluesky and in December 2025 I again created a profile on Linkedin, albeit without much enthusiasm (which is reflected in my activity there).

And why this return to two social media platforms, despite my distaste for these services? The answer is twofold: partly because I teach about the professional use of social media – including their role as tools for spreading fake news – and partly because it might seem odd that an Senior Lecturer in Computer Science, who has been an active user of the Internet/Web for dissemination since 1995, is not visibly present on any social media in 2025.

Some last ponderings

It all comes down to trust, but even so if we absolutely must be counted and measured, I think the most sensible is to forget about metrics offered by so called Academic Social Media tools and rather focus on papers in scientific journals (though, we have to deal with dubious impact factors also here), newspaper articles (that might reach the general public), and student assessments (that will tell us if we reached our students or not).

Also, I think it would be worthwhile to establish a system for peer reviewing of online lecture resources, like the former Intute project. This might encourage researchers to utilise blogs, wikis, etc. as parts of their lecturing, as well as potentially reaching a larger audience than just via journals. Though, again, we do not really know if the public actually search for such blogs, or that our particular field will generate any public interest. In fact, a small study done in 2013 concludes that most academic blogs are made for our professional peers, rather than for the general public. So perhaps we should be more than happy if we just manage to reach our students hearts and minds through our blogs and other social media tools?

While I am confident that most academics use social media tools appropriately, platforms such as ResearchGate and Impactstory may encourage what could be called “Facebook behaviour”: presenting an idealised image of thriving research activity and professional happiness. These tools can serve as mechanisms for maintaining visibility and securing one’s academic profile—a complex set of measures that might mislead management about the true presence and impact of one’s work. In short: Maskirovka, the academic way.

Addendum: What’s Changed as of December 2025

Since this post was first written, the academic communication landscape has evolved significantly:

  1. ResearchGate Metrics & Copyright
    • The RG Score was retired in 2022; current indicators (e.g., “Research Interest Score”) remain opaque and should be interpreted cautiously.
    • A 2023 settlement with major publishers introduced upload‑time rights checks and private sharing options, reducing—but not eliminating—copyright risk.
  2. ORCID and Persistent Identifiers
    • ORCID adoption is now near‑universal in many regions and required by funders and journals. Maintaining an up‑to‑date ORCID record is essential for compliance and interoperability.
  3. Open Access Mandates
    • Plan S continues to shape European OA policy, and the U.S. OSTP memo requires immediate public access to federally funded research by Dec 31, 2025. Repository‑based OA is now the default route; social networks should serve as signposts, not primary access points.
  4. Social Media Shifts
    • X/Twitter’s role in scholarly communication has diminished due to API restrictions and rising misinformation. Many academics have migrated to Bluesky or other platforms, though network effects remain a challenge.
  5. Altmetrics and Impact Evidence
    • Altmetrics are best treated as early attention signals, not definitive measures of impact. Combine them with citations, policy uptake, and qualitative evidence for a robust narrative.
  6. Metric Manipulation Risks
    • Citation gaming and AI‑generated content have increased, especially on Google Scholar.

I feel my core message is still relevant: Likes and follower counts are not proxies for societal impact. We should prioritise quality research, compliant open dissemination, and meaningful teaching evidence over vanity metrics.

Some interesting links for further reading


First published on LiveJournal.com: 03/10/2017. Edited and updated: 23/06/2021, 02/11/2022, 08/05/2024, 28/06/2025 and re-published 08/12/2025.

Case: Låste dører ved Universitetet i Lillevik

«Universitetssektoren er et enkelt og attraktivt sted å drive med spionasje»

Ola Kaldager, tidl. sjef E14

I en tid der krigen raser utenfor vår egen stuedør, og Russland og Kina driver en digital og analog skyggekrig mot både Norge og andre liberale demokratier, er universitetene ikke lenger en fredet oase. En rekke sikkerhetstiltak må nå implementeres, men hvordan gjøre dette slik at det er med å skape god sikkerhetskultur isteden for motstand? Det følgende case ser på et klassisk tilfelle.

Innledning

Universitetet i Lillevik har innført et vedtak om låste dører til ansattes kontorområder på flere studiested. Tiltaket ble annonsert uten at ledelsen offentliggjorde en åpen trusselvurdering eller forklarte hvilke alternativer som var vurdert. Beslutningen fører til sterke reaksjoner fra ansatte og studenter; redusert tilgjengelighet, spekulasjoner om hvem eller hva som utgjør trusselen, dører som bevisst holdes åpne – bl.a. ved at låsemekanismene dekkes av elektrikertape – i protest og et informasjonsvakuum fylt av rykter. Det igangsettes kampanjer mot låsing av dører og mot militarisering av Lillevik universitet. Noen opplever økt trygghet; andre opplever svekket tillit og frykt for at en symbolsk handling (sikkerhetsteater) skjuler reelle sårbarheter som ikke er skikkelig adressert.


Hva skjer i dette caset

  • Beslutningen er teknisk enkel, kommunikasjonsmessig svak: låste dører uten åpne, etterprøvbare trusselvurderinger.
  • Reaksjonene spenner fra støtte til aktiv motstand, der sikkerhetstiltaket blir direkte underminerte.
  • Resultatet: mulig sikkerhetsteater; synlige tiltak som gir følelse av trygghet uten å redusere reell risiko, kombinert med svekket sikkerhetskultur og institusjonell legitimitet.

Læringspunkter for beredskapsstudenter

  1. Skille mellom sikkerhetsteater og reell sikkerhet
    • Sikkerhetsteater: tiltak som er synlige og symbolske, men mangler risikobasert begrunnelse og måling.
    • Reell sikkerhet: krever trusselmodellering, konsekvensanalyse, målbare tiltak og kontinuerlig evaluering.
  2. Kommunikasjon som sikkerhetstiltak
    • Åpenhet om vurderingsgrunnlag, alternativer og konsekvensanalyse er en integrert del av effektiv risikohåndtering.
    • Manglende forklaring skaper informasjonsvakuum, rykter og motstand som undergraver sikkerheten.
  3. Legitimitet og sikkerhetskultur
    • Tiltak må være forankret i både faglige vurderinger og i dialog med brukerne for å opprettholde legitimitet.
    • Tillit fremmer samarbeid om rutiner; mistillit fører til sabotasje og dårlig etterlevelse.
  4. Risikoavveiing og brukerperspektiv
    • Sikkerhetstiltak må avveies mot tilgjengelighet, læringsmiljø og institusjonens samfunnsoppdrag.
    • Involvering av brukere reduserer utilsiktede konsekvenser og øker praktisk etterlevelse.

Sjekkliste for reell, risikobasert trygghet

  • Har ledelsen en skriftlig trussel- og sårbarhetsanalyse?
  • Er alternativer vurdert og dokumentert?
  • Er konsekvenser for læringsmiljø og tilgjengelighet analysert?
  • Finnes målbare suksesskriterier og kontrollmekanismer (f.eks. tilgangslogger, øvelser)?
  • Er kommunikasjonsplan og involveringsstrategi implementert?
  • Er det en plan for revisjon og læring basert på erfaringer?

Praktiske øvelser

  • Øvelse 1 — Rask risikovurdering (30–45 minutter)
    Bruk forumet i Canvas til å organisere dere i team (maks 6 deltakere pr. team). Benytt så Microsoft Teams (dere har tilgang til Nord universitet sin Office-pakke for studenter) som verktøy for samhandling. Hvert team lager deretter en kort trusselvurdering for å begrunne (eller avvise) låsing av kontordører ved et studiested. Teamene skal identifisere aktør, motivasjon, sannsynlighet, konsekvens og foreslå tre alternative tiltak med kost-/nyttevurdering.
  • Øvelse 2 — Kommunikasjonsplan (45 minutter)
    Hvert teame utarbeider en kommunikasjonsstrategi for ledelsen: Hvilke fakta deles; hvilke usikkerheter opplyses; hvordan involveres studenter og ansatte; tidslinje for evaluering og justering.
  • Øvelse 3 — Rollelek: å håndtere motstand (30 minutter)
    Simuler et digitalt allmøte via Teams med ansatte og studenter hvor ledelsen presenterer beslutningen. Et team spiller ledelse, et team skeptikere. Øv på åpen dialog, svar på kritikk og konkrete tiltak for å bygge tillit.
  • Oppgave etter økten
    Skriv et kort notat (max 800 ord) med anbefalt vei videre for Universitetet i Lillevik: beslutningsgrunnlag, kommunikasjon, implementeringskontroller og evalueringspunkter. Begrunn synspunktene i relevant litteratur, med kildehenvisning i tekst i tråd med APA-stilen. Legg så inn et refleksjonsnotat (eget kapittel) i notatet der både teamenes og den enkeltes tanker om individuelle og felles læringsprosesser og utbytte knyttet til det å jobbe med dette arbeidskravet beskrives. Til endelig innlevering (mappestenging) tas også med eventuelle endringer som er utført etter råd/veiledning. Dette gjøres i et eget underkapittel i fellesdelen . Helt til slutt i notatet skal det settes opp en litteraturliste i APA-stilen.

Refleksjonsspørsmål til slutt

  1. Hvordan burde ledelsen i dette caset balansert behovet for å publisere en redigert trusselvurdering for å bygge legitimitet og medvirkning mot risikoen for at offentliggjorte opplysninger svekker operasjonell sikkerhet?
  2. Hvordan kan man balansere behovet for tilgjengelighet i akademia mot kravet om sikkerhet?
  3. Når blir et synlig sikkerhetstiltak mer skadelig enn nyttig for den totale sikkerheten?
  4. Hvilke kommunikasjonsprinsipper ville du brukt for å unngå informasjonsvakuum og rykter i dette caset?
  5. Hvordan ville du målt om låste dører faktisk reduserer relevant risiko?

Leseliste

Når akademia blir frontlinje: Digital beredskap i møte med etterretning, kriminalitet og kriser

Dette innlegget er en del av min formidling tilknyttet Nasjonal sikkerhetsmåned 2025, og er utgangspunktet for følgende innlegg i medier:

1) Digital beredskap er en borgerplikt, Nordnorsk debatt, 07.10.25

2) Oktober i akademia: Digital beredskap når Russland og Kina banker på labdøra, Avisa Nordland, 08.10.25

Innledning

Oktober er sikkerhetsmåned – i Norge koordineres kampanjen av NorSIS/NSM med årets tema digital beredskap. Målet er å løfte sikkerhet fra «IT-oppgave» til ledelsesansvar, kultur og øvelse – i hele virksomheten. Parallelt markerer EU European Cybersecurity Month, ledet av ENISA. Begge minner oss om at robusthet bygges gjennom kontinuerlig arbeid, ikke én måned i året.

«Når en person styrker sin digitale bevissthet, styrker vi også Norges samlede digitale robusthet. Med den økte aktiviteten blant kriminelle på nett og dagens sikkerhetspolitiske situasjon er dette viktigere enn noensinne» skriver NorSIS og NSM i sin rapport «Nordmenn og digital sikkerhetskultur 2025».

Hva betyr dette for oss i akademia?

Norsk akademia er attraktiv – og åpen

Denne åpenheten gir vitenskapen kraft, men utnyttes også av fremmede staters tjenester som tålmodig setter sammen «biter» fra konferanser, prosjekter og digitale plattformer til strategiske fordeler. Norske trusselvurderinger peker særlig på Russland og Kina som drivere av etterretning, påvirkning og sammensatte operasjoner mot forskning, næringsliv og kritisk infrastruktur.

Samtidig er ikke trusselen kun «statlig». Løsepengeangrep, tredjeparts‑sårbarheter og sosial manipulering rammer utdannings- og helsesektor globalt – ofte gjennom kjente svakheter og menneskelige feil.

Hvorfor akademia er en frontlinje – og hva «digital beredskap» faktisk betyr

Forskningens attraktivitet + digitalt økosystem + åpen kultur = høy risiko

Etterretning og påvirkning utgjør en økende trussel mot europeisk forskning og teknologimiljøer, både fysisk og digitalt, slik E‑tjenestens Fokus 2025 og PSTs nasjonale vurdering understreker. Samtidig viser Riksrevisjonens funn fra 2024 at operasjonell sårbarhet i sektoren er betydelig: penetrasjonstester ga full kontroll i to universitets- og høyskolevirksomheter, og forskeres utstyr ble kompromittert i en tredje – et tydelig tegn på mangelfull styring, oversikt og etterlevelse.

Globalt rapporterer utdanningssektoren vedvarende press fra løsepengeangrep og datatyveri, der phishing og utnyttelse av sårbarheter er de mest brukte inngangsveiene. I denne konteksten blir digital beredskap – evnen til å forutse, forebygge, respondere og gjenopprette på teknisk, organisatorisk og menneskelig nivå – avgjørende for hele verdikjeden, og står sentralt i den nasjonale kampanjen for 2025.

Styringssignaler: Åpen – men ikke naiv

Det norske forskningssystemet skal være «så åpent som mulig, så lukket som nødvendig». Regjeringens Meld. St. 14 (2024–2025) løfter forskningssikkerhet som nøkkel for å bevare åpenhet. Fra 2025 forventer Forskningsrådet at prosjekter vurderer og håndterer forskningssikkerhet for å få støtte. HK‑dir presiserer at styring av informasjonssikkerhet og personvern er en del av sektoransvaret og skal forsterkes.

På EU‑nivå kom Rådets anbefaling om forskningssikkerhet våren 2024 (undønsket kunnskapsoverføring, utenlandsk påvirkning, etikk/integritet), og ENISA fulgte opp NIS2 med teknisk gjennomføringsveiledning som konkretiserer krav til risikostyring og tiltak. I norsk kontekst er kravene også skjerpet via digitalsikkerhetsloven.

Hva sier trussel- og risikobildet?

Russland og Kina intensiverer sin innsats innen etterretning, påvirkning og fordekte operasjoner, med særlig fokus på teknologi, energi, maritim og arktisk aktivitet – samt kunnskapssektoren. Samtidig endrer kriminelle taktikk, med økt bruk av datatyveri og utpressing uten kryptering, større utnyttelse av tredjepartsleverandører og rask masseutnyttelse av sårbarheter. I takt med denne utviklingen skjerpes både nasjonale og internasjonale regelverk og forventninger, noe som stiller høyere krav til sikkerhet og beredskap på tvers av sektorer.

Avslutning

Digital beredskap i akademia handler om faglig aktsomhet like mye som brannmurer. Vær åpen, men ikke naiv. Kartlegg verdier, kjenn truslene, bygg tiltak inn i prosjektløpet, og ikke minst – øv. Det hjelper ikke med Nano elæringskurs hvis de ansatte aldri øves. Det er slik vi beskytter forskningsfrihet, samfunnsoppdrag og nasjonal sikkerhet.

Leseliste

  1. Trusselvurderinger 2025: PST NTV og E‑tjenesten FOKUS 2025.
  2. NSM Risiko 2025sårbarheter, tiltak og anbefalinger.
  3. Digitalsikkerhetsloven (NIS2) – NSM veileder (2025).
  4. Meld. St. 14 (2024–2025): Sikker kunnskap i en usikker verden
  5. Sikt – Cybersikkerhetssenteranbefalinger (verdikart, klassifisering, kontinuitet, tiltakskort mot løsepengevirus).
  6. NCSC (NSM/NorCERT)nasjonal responsfunksjon for alvorlige cyberangrep.
  7. REN‑ISAC – hendelseshåndtering og deling for høyere utdanning (NA). ren‑isac.net
  8. MITRE ATT&CKfelles taksonomi for angripernes taktikker/teknikker (TTPs).
  9. OECDIntegrity and security in the global research ecosystem.
  10. NATO CCDCOEbiblioteksamling og håndbøker for cyberoperasjoner/beredskap.

Se også

Mine faglige arbeider knyttet til informasjonssikkerhet og digital beredskap